Claude Opus 5.5 提示词官方指南:删掉 think hard、Medium 档起步(11月)
Anthropic 官方指南把 Claude Opus 5.5 设为 Pro/Max/Ultra/Team 默认模型,并建议删掉 think hard 类提示词、从 Medium 档起步。本文整理七条要改的提示词习惯、API 侧变化、价格表与第三方单任务成本数据。



BLUF:Claude 提示词的写法正在换代。 Anthropic 11 月 12 日发布知识工作指南《Using Claude Opus 5.5 as your daily driver for knowledge work》,把 Opus 5.5 设为 Pro/Max/Ultra/Team 全部付费档的默认模型,并要求用户丢掉旧世代习惯:删掉「think hard」类措辞、从 Medium 档起步。本文整理指南要点、API 侧变化与第三方成本数据。
为什么「think hard」反而拖慢 Opus 5.5?
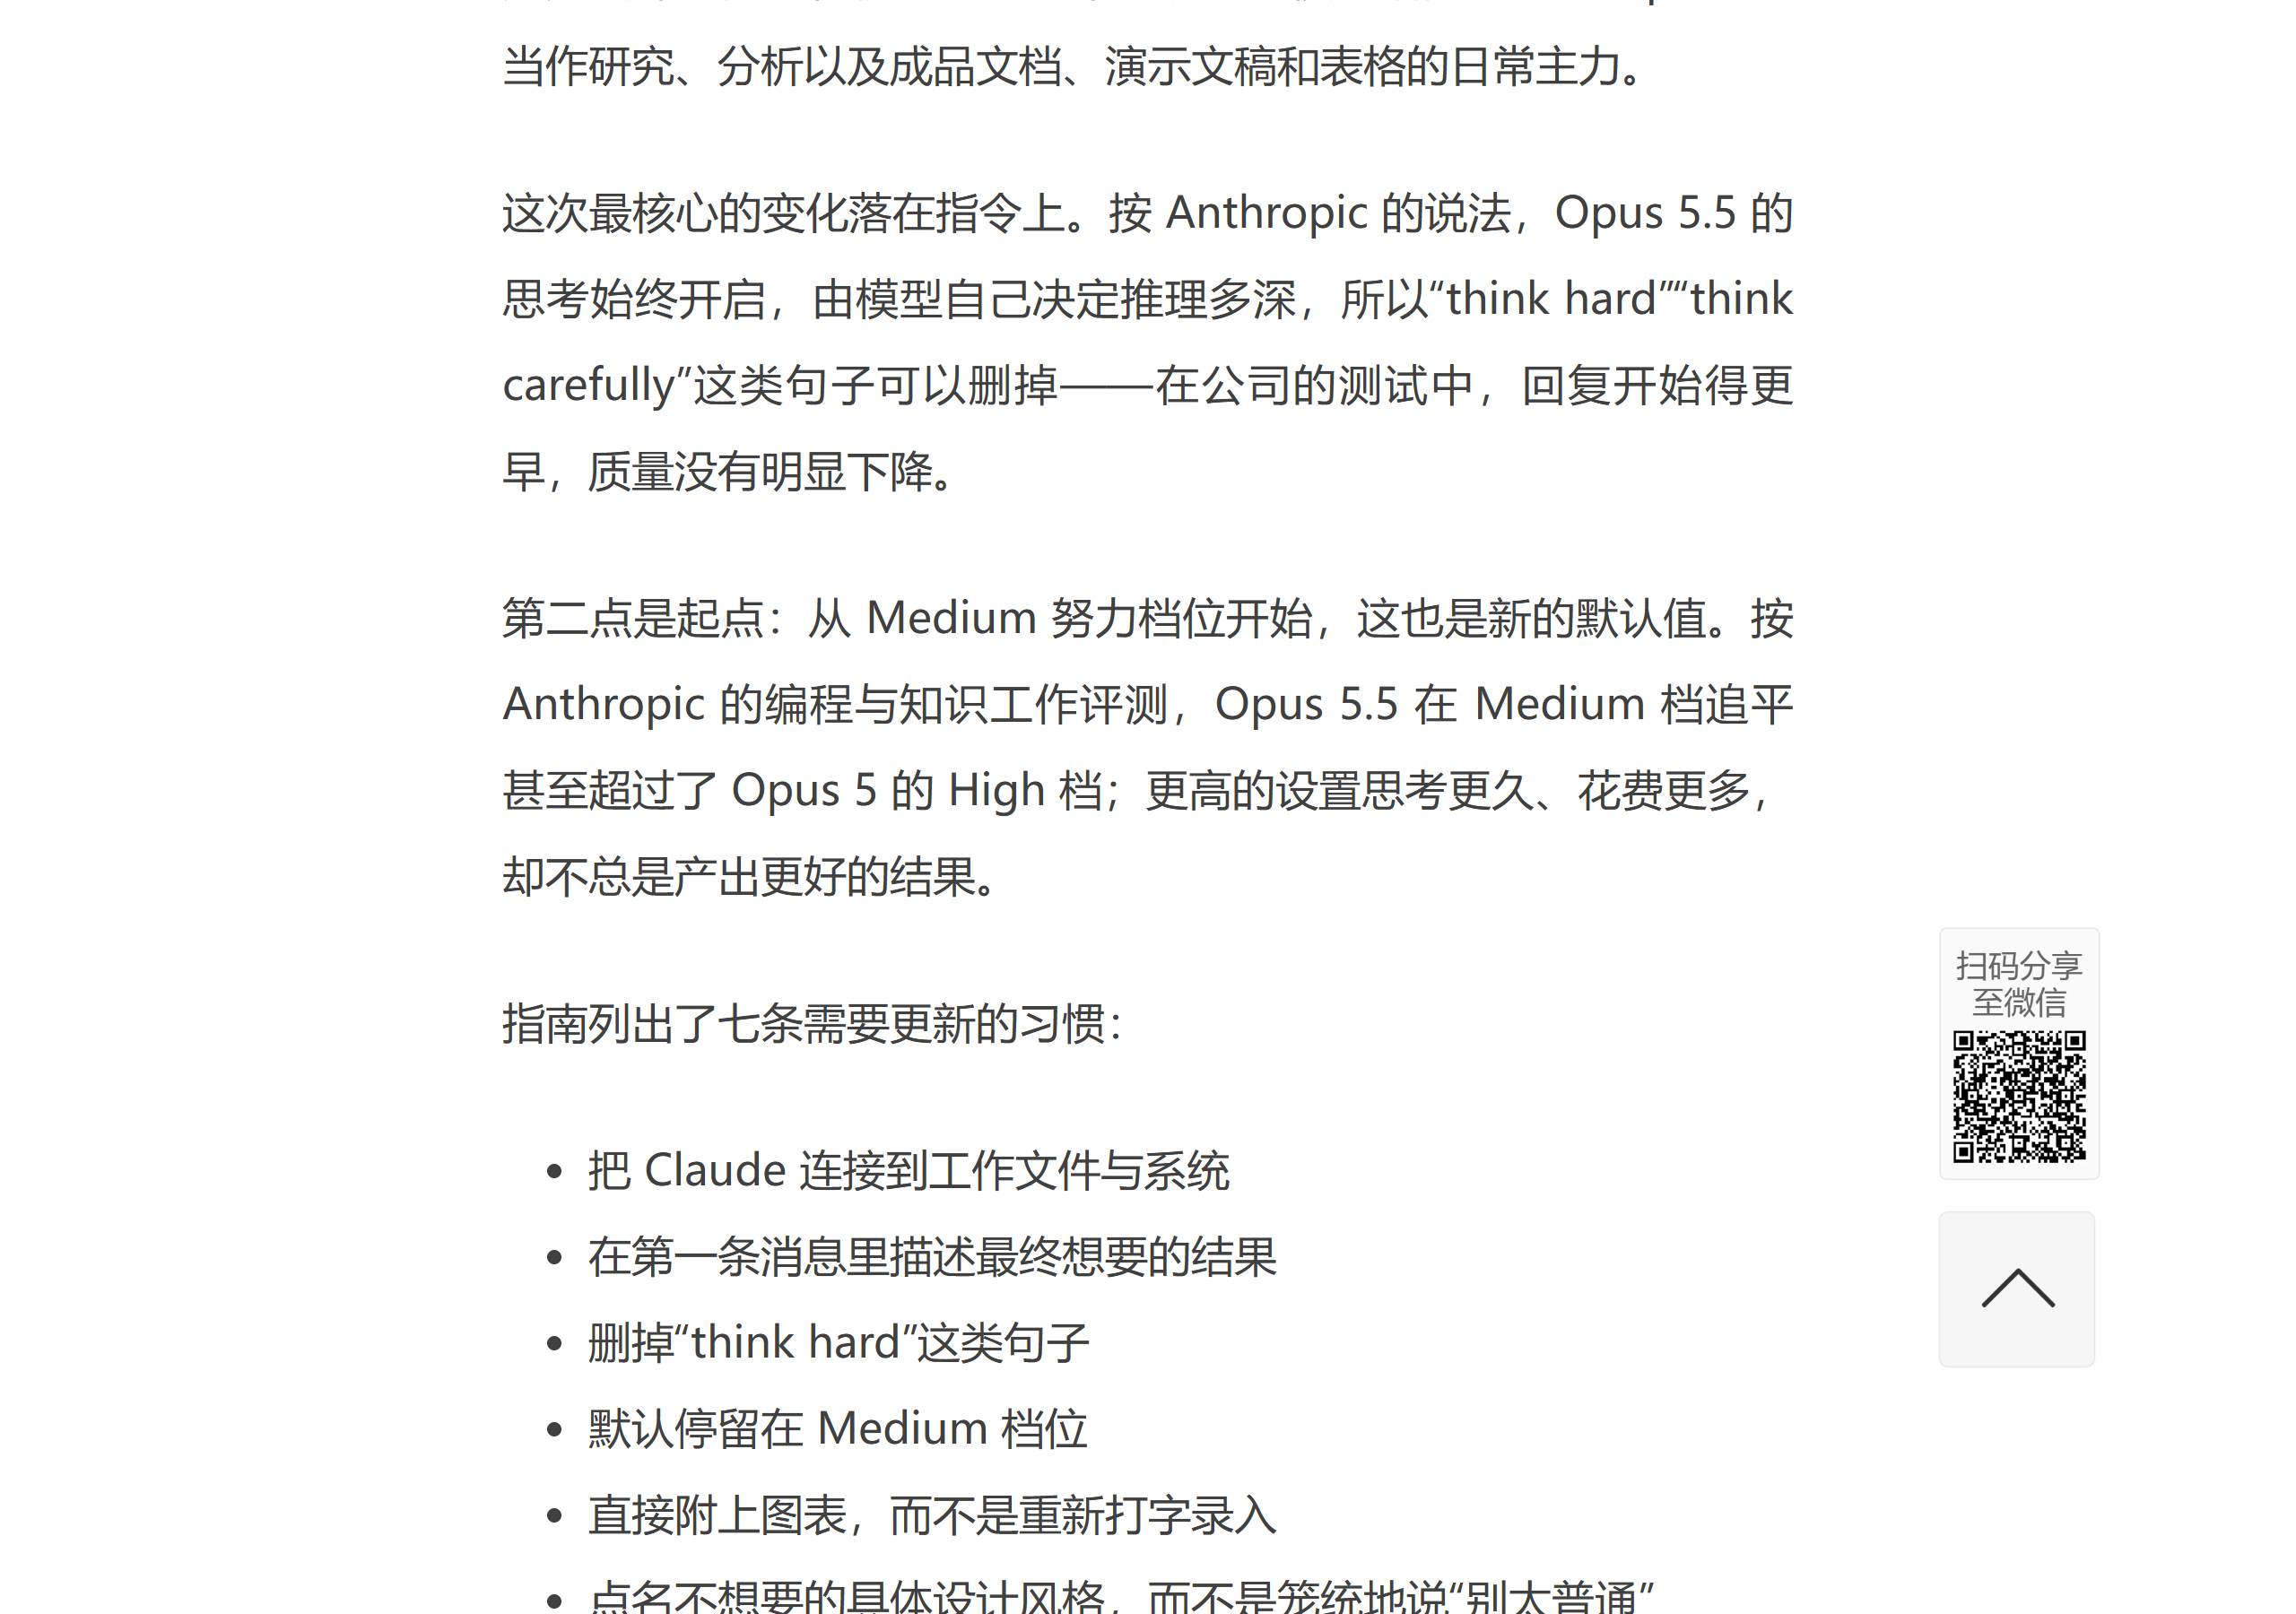
Opus 5.5 的思考始终开启,由模型按任务难度和 effort 档位自行决定推理深度,这是与旧代模型的根本差异。Anthropic 测试称,删掉「think hard」「think carefully」后响应更快、质量无可测下降——这类短语源自约一年半前推理模型早期,如今已成冗余。API 侧变化更直接:thinking 设为 disabled 现在返回 400 错误;让模型先写出推理再作答,可能触发 reasoning_extraction 拒答,官方做法是直接读 thinking blocks。
Medium 档为什么够用?
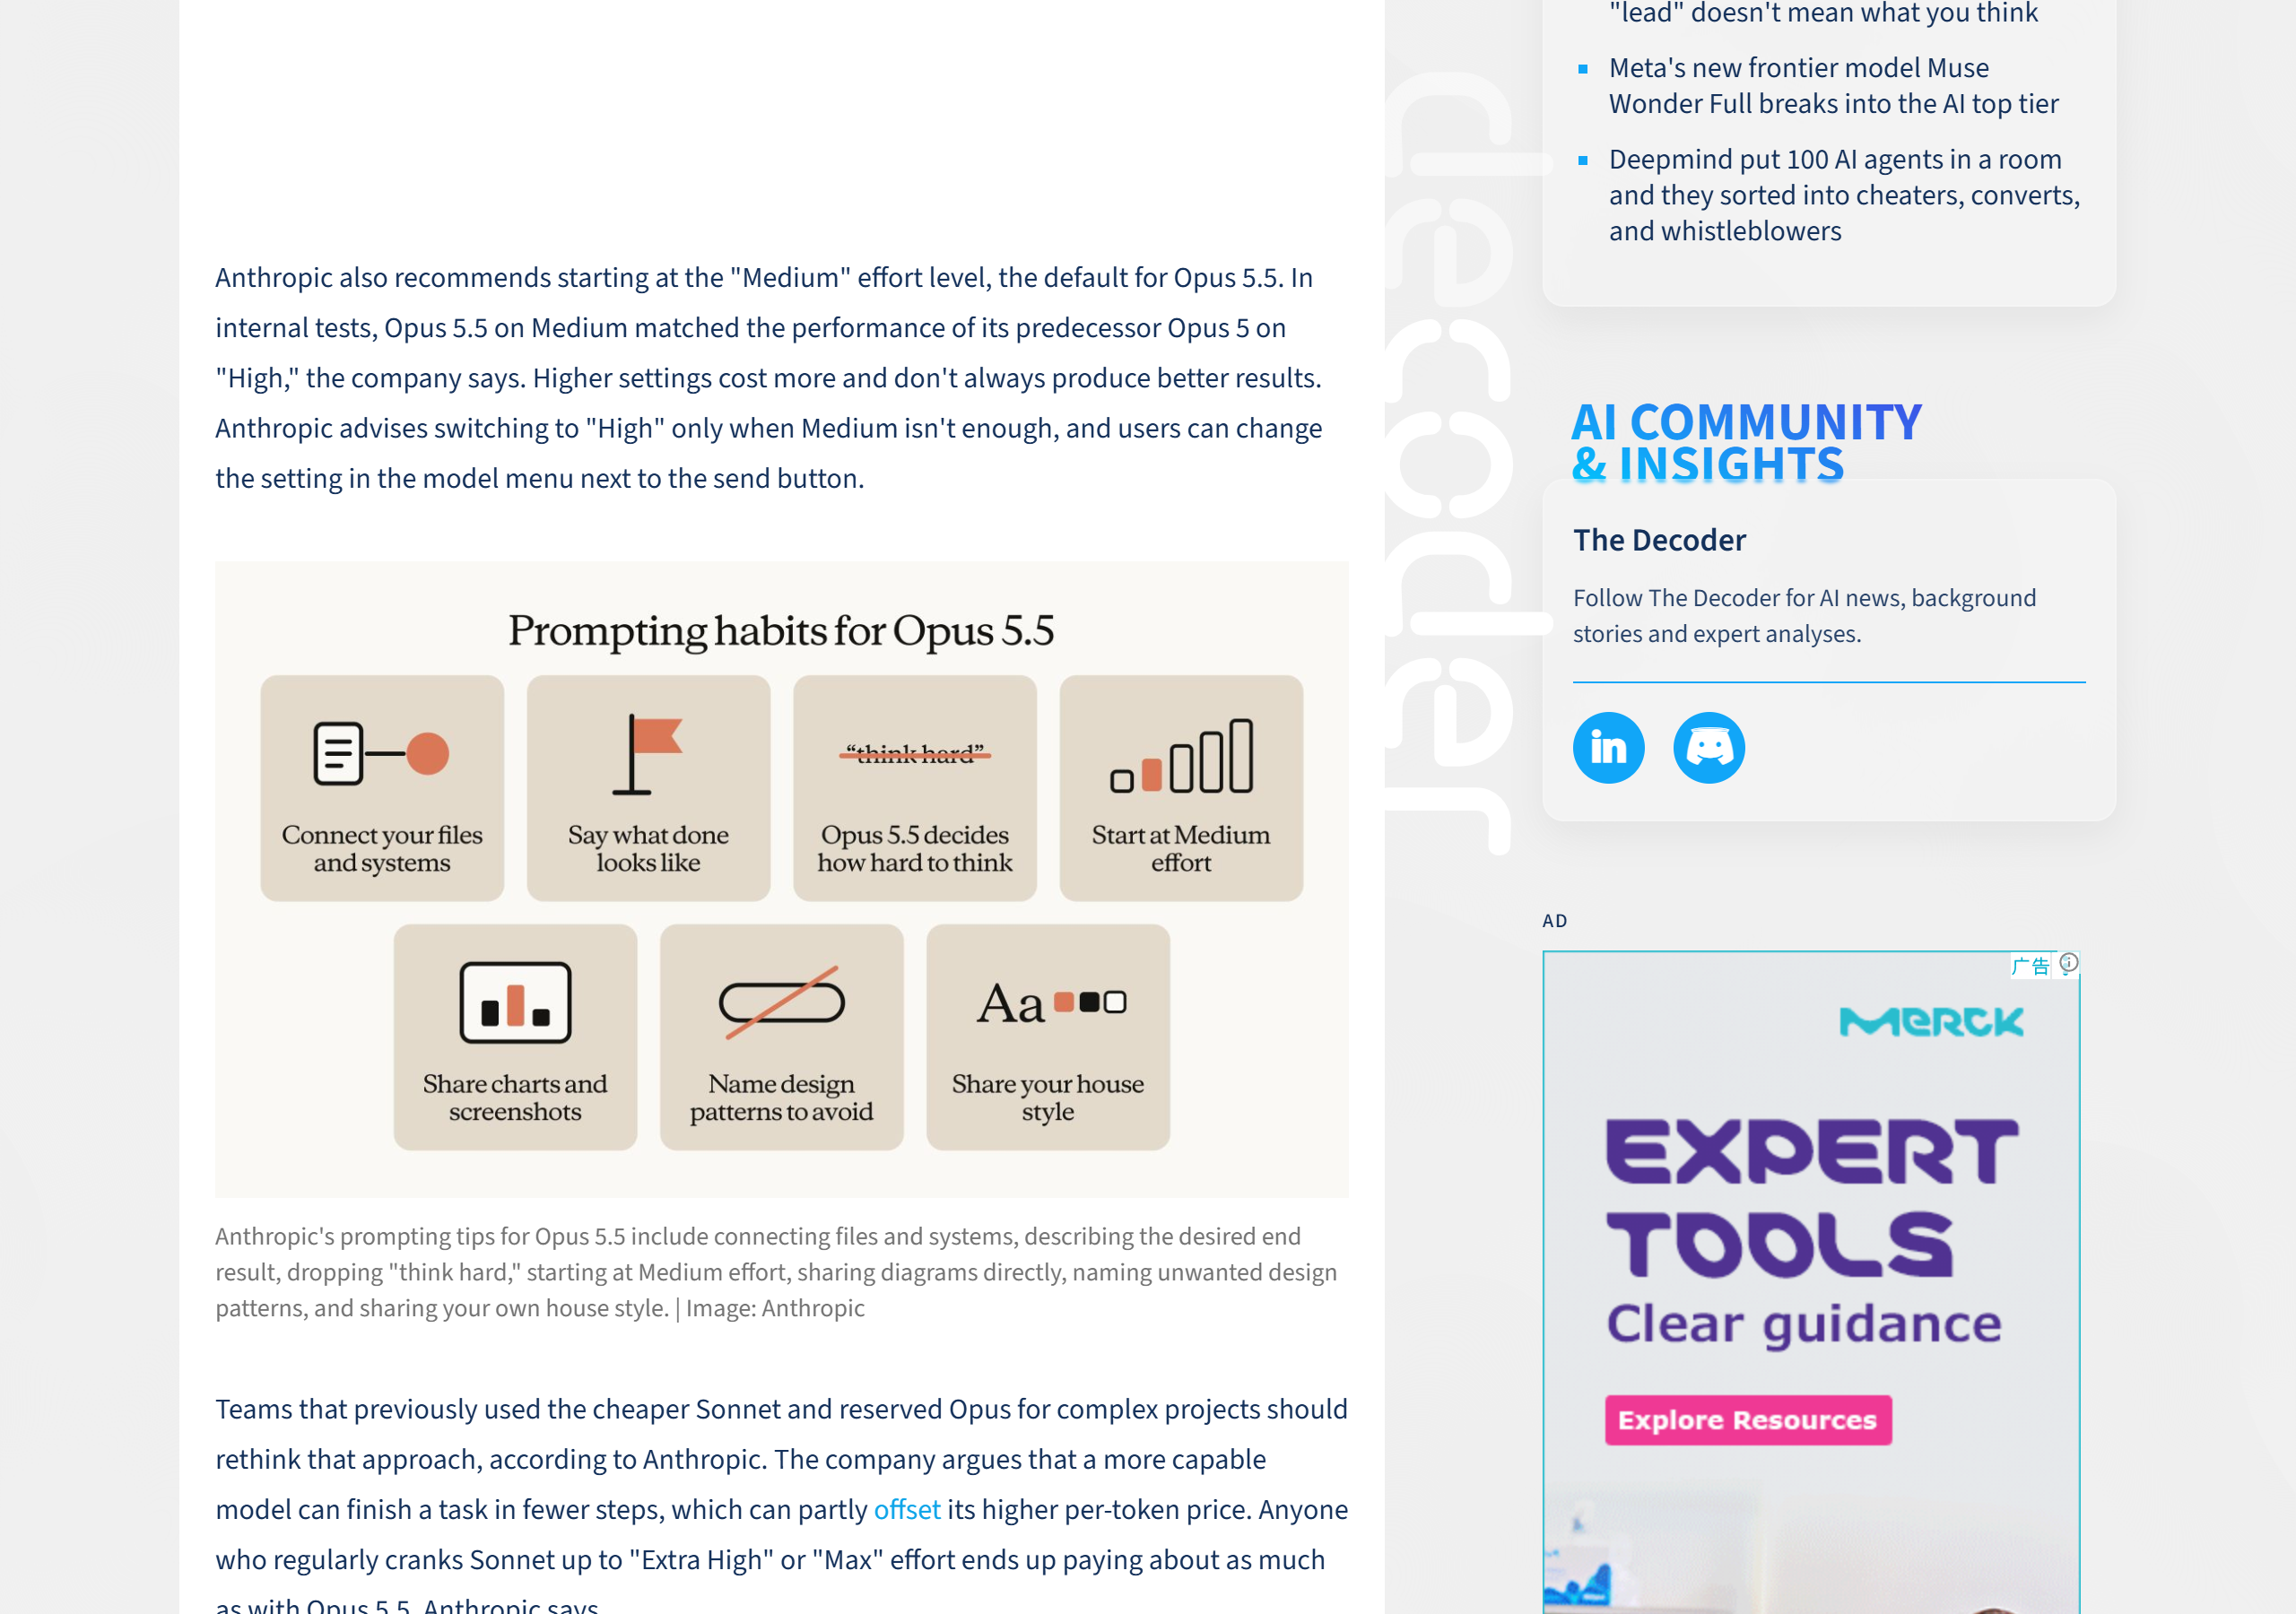
Medium 是新默认档。官方口径:编程与知识工作评测中,Opus 5.5 的 Medium 档追平 Opus 5 的 High 档——CursorBench 4.0 上 Medium 得 52.5%,Opus 5 拉满 Max 档只有 46.6%,成本约为后者五分之一;FrontierCode 上 Medium 54.6% 与 Max 54.4% 几乎持平。官方建议只在 Medium 卡住时再升 High,入口在 Claude 发送按钮旁的模型菜单。
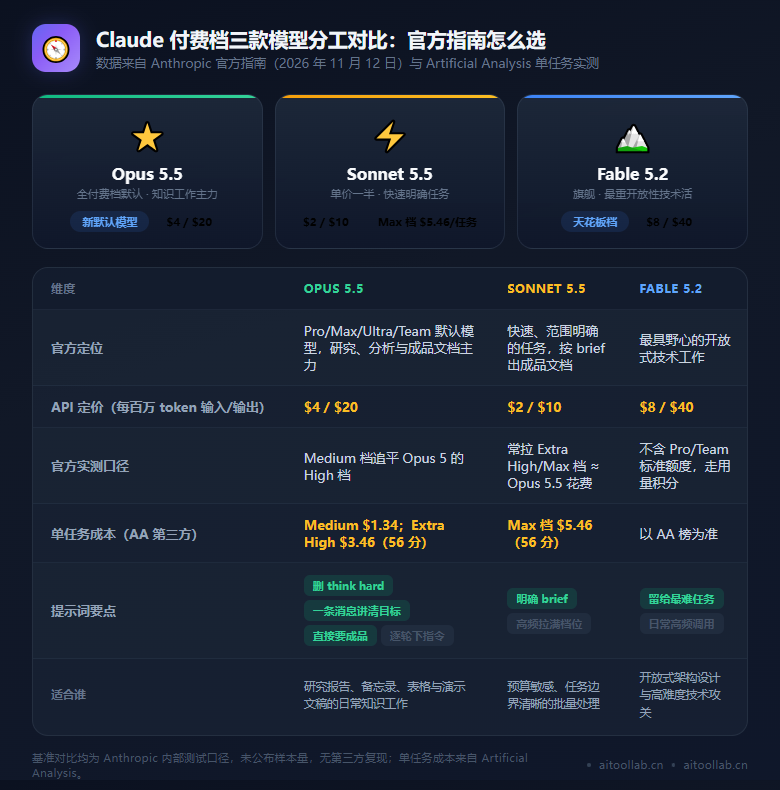
价格参考(每百万 token 输入/输出):Haiku 5.5 为 0.10/0.50 美元(100K 上下文内),Sonnet 5.5 为 2/10 美元,Opus 5.5 为 4/20 美元,Fable 5.2 为 8/40 美元。
还有哪七条习惯要一起改?
指南把 Opus 5.5 定位成「委派对象」而非逐轮引导:一条消息讲清目标、输出格式和何时停下来提问;直接要成品文档或表格,不要先要草稿,官方称常能一次过;图表直接附原图,别手动转录数值——低档读密集图表已比 Opus 5 高档更准;设计任务点名不要的具体元素(奶油色背景、胶囊按钮),比「别太普通」有效;把行文风格或品牌规范贴给它;用连接器接入文件与系统让它自己取数;最后是重新考虑 Sonnet-first 分工。
三款模型怎么分工最省钱?我们把价格、默认档位与第三方单任务成本做成了信息图。
Sonnet 便宜论还成立吗?
按 token 单价 Opus 5.5 是 Sonnet 5.5 的两倍,但按任务算账会反转。Artificial Analysis 数据:Sonnet 5.5 拉到 Max 档单任务 5.46 美元得 56 分,Opus 5.5 的 Extra High 档同样 56 分只要 3.46 美元;Medium 档 1.34 美元,比 Sonnet Extra High 的 2.01 美元便宜约三分之一。API 文档还给了保守口径:SWE-bench Pro 子集上,Opus 5.5 low 档与 Sonnet 5.5 默认档解决率相当,每解决一个任务成本仅高约 7%。官方另引用实测:一份虚构并购分析 63 分钟完成,Opus 5 需 93 分钟且成本翻倍;18 份生成报告中 16 份通过逐数字与引文自动核验。
哪些结论要打折听?
所有基准对比均为 Anthropic 内部测试,未公布分数细节与样本量,无第三方复现。两笔账是否在自己的工作负载上成立,建议用真实任务量一下 token 与步数。另注意 Fable 5.2 不含在 Pro 与 Team 标准额度内,走用量积分计费。写代码的场景,effort 参数同样适用于 Claude Code,最重的开放性技术活再上 Fable 5.2。
❓ 常见问题
不需要。Opus 5.5 思考常开、自适应推理,官方测试显示删掉这类短语后响应更快且质量无明显下降;API 上把 thinking 设为 disabled 已直接返回 400 错误。
从默认的 Medium 档起步。官方称 Medium 档已追平 Opus 5 的 High 档,更高档位更贵却不总产出更好结果,建议只在 Medium 卡住时升到 High,入口在发送按钮旁的模型菜单。
建议重算一笔账。Artificial Analysis 数据显示 Sonnet 5.5 拉到 Max 档单任务 5.46 美元,Opus 5.5 Extra High 档同分只要 3.46 美元,把 Sonnet 拉满档位已不再便宜。
基准对比均为 Anthropic 内部测试口径,未公布分数细节与样本量,无第三方复现。建议用自己的真实任务实测 token 用量与步数,再决定是否调整模型分工。