Claude Sonnet 5.5 发布:编程反超 Opus、与 GPT-6 Sol 同价开打(2026年9月)
Anthropic 于 9 月 28 日发布 Claude Sonnet 5.5:输出快 30% 以上、单任务成本最高降 30%,Terminal-Bench 4.0 编程跑分反超 Opus 5.5,与 GPT-6 Sol 同价为 2/10 美元每百万 Token,并首次下放旗舰级网络安全防护。


9 月 28 日,Anthropic 发布 Claude 5.5 家族第二款模型 Claude Sonnet 5.5,距 Opus 5.5 仅六天:输出快 30% 以上、单任务成本最高降 30%,定价维持每百万 Token 输入 2 美元/输出 10 美元——与 GPT-5.6 Sol 完全同价,中档模型第一次在同价位正面对撞。
跑分:编程反超自家旗舰
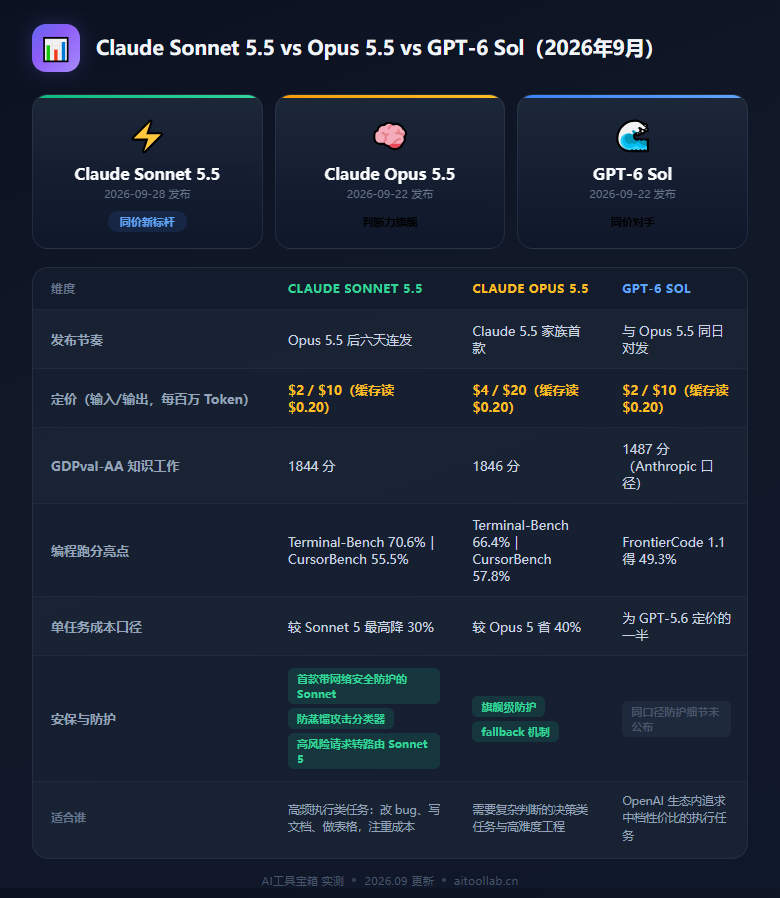
Claude Code 2.1.284 当日已把默认 Sonnet 切为 5.5。Terminal-Bench 4.0 上 Sonnet 5.5 拿 70.6%,远超前代 Sonnet 5 的 10.3%,也高于 Opus 5.5 的 66.4%;CursorBench 4.0 得 55.5%,距 Opus 5.5 的 57.8% 差 2 分。知识工作 GDPval-AA 拿 1844 分,与 Opus 5.5 的 1846 分只差 2 分,同口径下 GPT-6 Sol 为 1487 分(Anthropic 数据)。官方还称它是首款仅凭截图通关《宝可梦 红》的 Sonnet。
同 token 单价,更省的账单
定价与 Sonnet 5 持平,省钱逻辑在「每任务更省」:官方称低/中推理档约十分之一的成本即可超过 Sonnet 5 的最佳成绩。独立平台 Artificial Analysis 提醒另一面:最高推理强度下,Sonnet 5.5 的单任务平均输出 Token 消耗为各模型之最,推理档位怎么选仍是成本与质量间的手工活。
首款带网络安全防护的 Sonnet
因网络安全能力大幅提升,Sonnet 5.5 首次引入旗舰同款防护:高风险请求显式转路由到 Sonnet 5,专业用户可经 Cyber Verification Program 申请分层准入,并新增防蒸馏攻击分类器。Anthropic 强调本模型未推进能力前沿。Haiku 5.5 将于未来几周发布,补齐家族末端——Fable 对 Astra、Opus 对 Sol 的档位图就此对齐。
下图为三款模型核心维度信息图对比。
选型建议
高频执行类任务(改 bug、写文档、做表格)优先在 Sonnet 5.5 跑通;需要判断力的复杂决策留在 Opus 5.5;批量任务可等 Haiku 5.5。对 ChatGPT 与 Claude 双订阅用户来说,这轮同价对撞让「够用」与「最贵」的差距进一步抹平。
❓ 常见问题
每百万 Token 输入 2 美元、输出 10 美元、缓存读取 0.20 美元,与 Sonnet 5 持平;由于每任务消耗的 Token 更少,官方称单任务成本最高可降 30%。
编程基准已经反超(Terminal-Bench 4.0 为 70.6% 对 66.4%),知识工作 GDPval-AA 只差 2 分;但官方定位上,需要复杂判断的决策类任务仍建议用 Opus 5.5。
两者定价完全相同(2/10 美元每百万 Token)。Anthropic 口径的 GDPval-AA 中 Sonnet 5.5 得 1844 分、GPT-6 Sol 得 1487 分,但这是厂商自家数据,建议用真实任务实测后再定。
已上线 AWS、Google Cloud、Azure 三大云平台,模型 ID 为 claude-sonnet-5-5,支持零数据保留;跨境使用前请自行确认所在地区的合规要求。