本地部署大模型要多少显存?2026 显卡、量化与框架选型
本地部署大模型要多少显存?这篇用 Ollama 与 LM Studio 官方数据算清权重体积和上下文占用,给出显卡驱动门槛、量化取舍,以及 Ollama、LM Studio、vLLM 分别适合谁用。

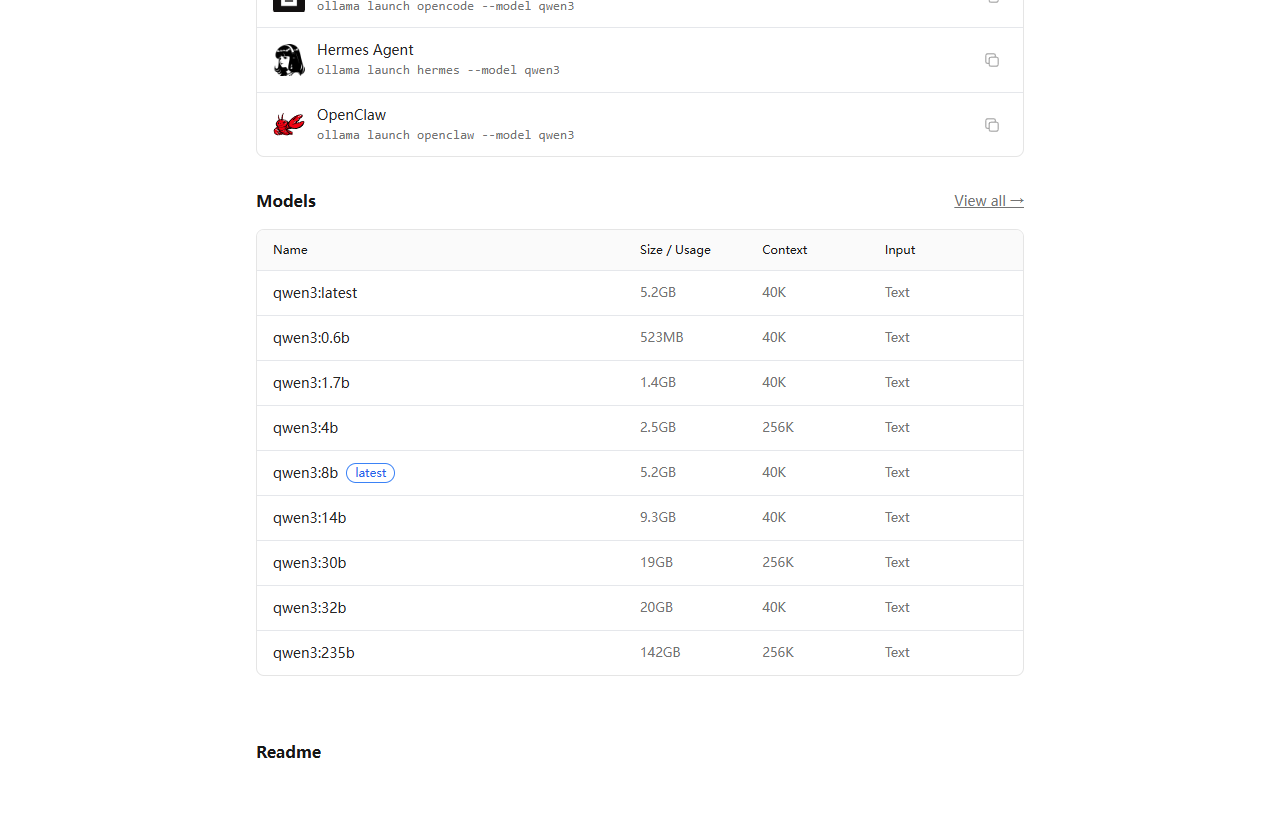
想在本地部署大模型,先看显存和内存够不够。省事的办法是拿官方模型库列出的文件体积当权重下限,再给上下文留余量:Ollama 模型库里 qwen3 的 8B 版本 5.2GB、14B 9.3GB、30B 19GB;LM Studio 官方系统需求写的是 Windows 机器内存至少 16GB、独显显存至少 4GB 起步。8GB 内存的笔记本也能跑,只是要挑小模型、把上下文开小。
一、两家官方给的硬件基线
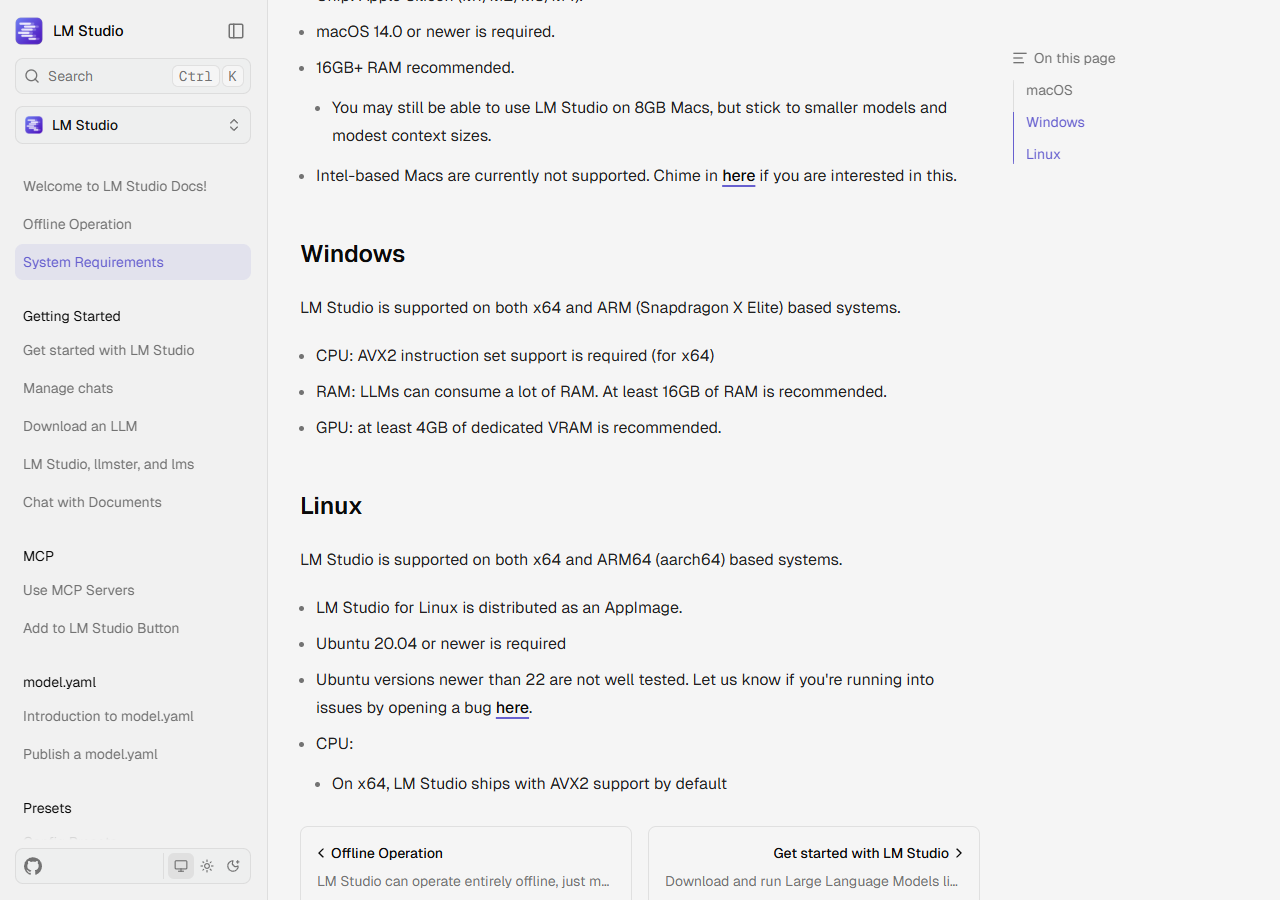
LM Studio 的系统需求页把三套系统都列了。macOS 要 Apple Silicon(M1 及以后)加 macOS 14 以上,建议 16GB 内存起,Intel 芯片的 Mac 不在支持范围。Windows 分 x64 和 ARM(骁龙 X Elite),CPU 要支持 AVX2,内存建议 16GB 以上,独显显存建议 4GB 以上。Linux 发的是 AppImage,Ubuntu 20.04 起步。
二、显存要多少:拿官方模型体积当尺子
Ollama 模型库把每个尺寸的文件体积都标出来了:qwen3:0.6b 523MB、1.7b 1.4GB、4b 2.5GB、8b 5.2GB、14b 9.3GB、30b 19GB、32b 20GB、235b 142GB。这些就是下载要占的空间,也基本等于权重那部分要吃的显存,Ollama 默认尽量把模型层放进显存,放不下才退回内存。
三、驱动和显卡门槛
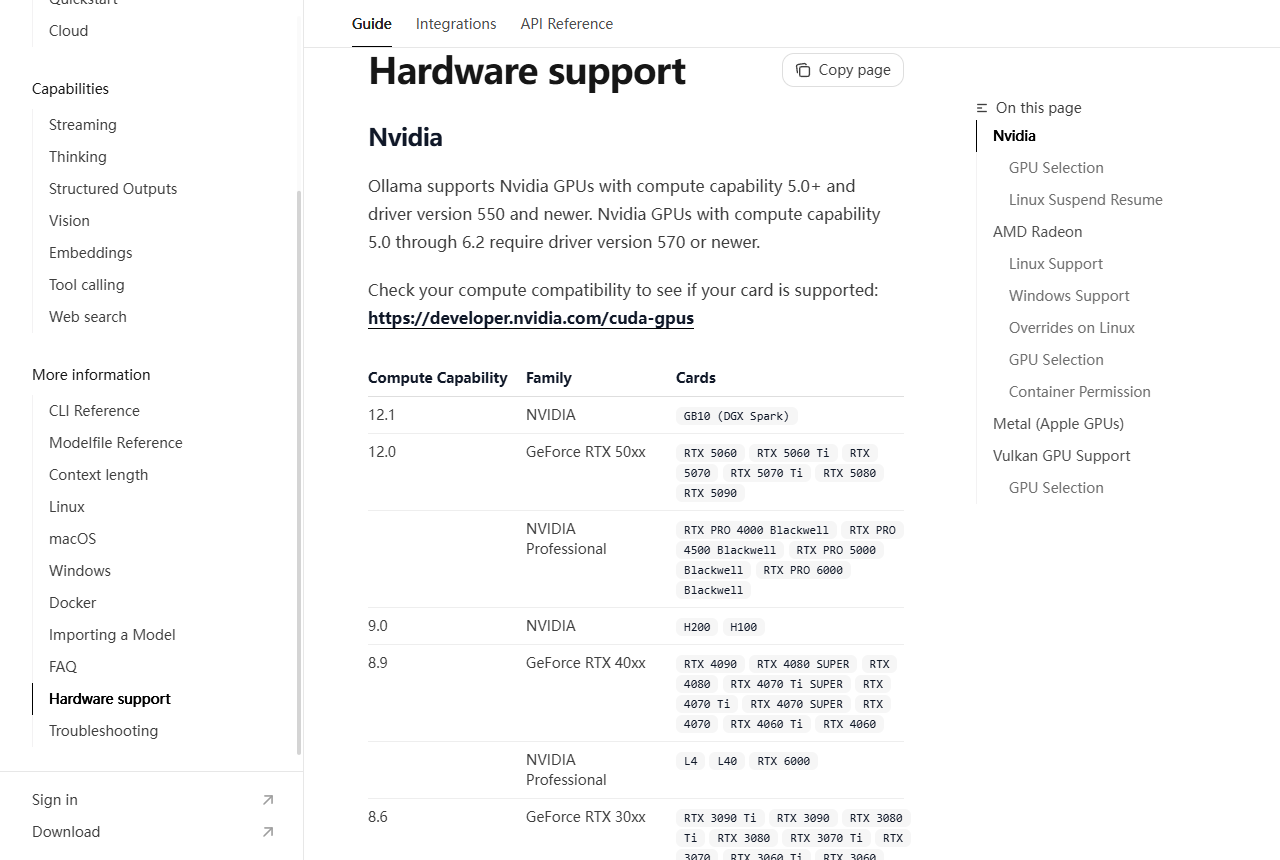
Ollama 硬件支持页写得很细:N 卡算力 5.0 以上、驱动 550 及以上,算力在 5.0 到 6.2 之间的老卡要 570 以上。RTX 30、40、50 系都在支持表里,装之前先确认自己的卡在不在表内。
四、显存不够的两条路:量化、调上下文
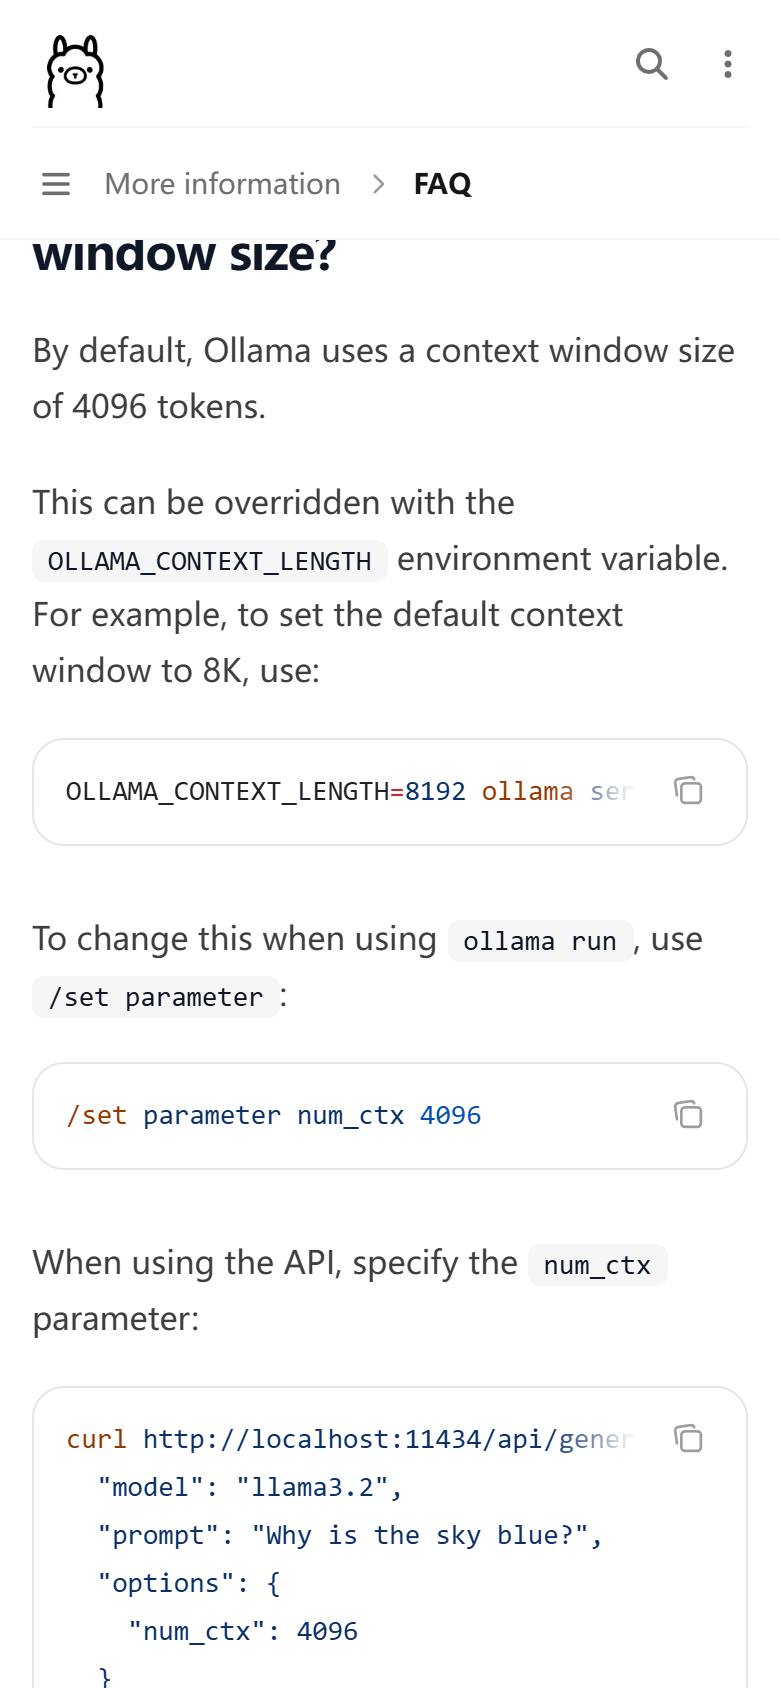
量化是把权重从 16 位压到 4 位(GGUF 里的 Q4_K_M 这类),体积能降到四分之一上下,代价是精度有一点损失,llama.cpp 官方建议配 imatrix 校准来减小损失。上下文同样吃显存:Ollama 默认 4096 token,可以用 OLLAMA_CONTEXT_LENGTH 调大,调之前先看还剩多少显存。跑起来用 ollama ps 看 PROCESSOR 列,100% GPU 就是整模型在显卡上,出现 CPU 字样说明显存不够、退到内存了。
五、框架怎么选
自己试玩,Ollama 命令行最省事;LM Studio 适合想用图形界面的人,下载模型、拖文件聊天都在窗口里点。要让多人同时调用,或者给内部系统做服务,换 vLLM:它用 PagedAttention 管 KV cache、支持连续批处理和张量并行,对外给 OpenAI 兼容接口,量化支持 FP8、INT8、GPTQ、AWQ、GGUF。
我的顺序是:先按模型体积挑一个装得下的尺寸,跑起来看 ollama ps,掉到 CPU 再回去调上下文或换量化版。想按显存分层挑机器,看站内本地部署完整指南;工具入口在 Ollama。官方原文:Ollama FAQ、LM Studio 系统需求、vLLM 文档。
❓ 常见问题
没有统一数字,看你要跑多大的模型。Ollama 模型库给的参考是 qwen3:8b 权重 5.2GB、14b 9.3GB、30b 19GB,显存还要额外留给上下文。LM Studio 官方建议 Windows 独显显存 4GB 以上起步,4GB 显存跑 4B 以下的量化小模型比较稳,想上 14B 级别按文件体积推算至少要 10GB 上下。
能,但要挑小的。LM Studio 官方说 8GB 的 Mac 仍然可用,前提是选小模型、上下文开小。同样思路放到 Windows 上,就是选 1.7B 到 4B 的量化版,把上下文控制在 4096 token 左右,别一上来就试 14B。
软件本身免费。Ollama、LM Studio、vLLM 都能免费下载,开源协议也不限制商用。真正花钱的是硬件和电费。偶尔用一两次,租云 GPU 按小时计费通常比自己买显卡划算;天天跑再考虑配本地机器。
用 ollama ps 看 PROCESSOR 列。写着 100% GPU,说明整个模型都在显卡上;出现 100% CPU,或者写成百分比的混排,说明显存放不下、系统把一部分退回了内存,出词速度会明显变慢。