Qwen3.8-Omni-Flash 发布:1M 上下文全模态,音视频智能体开始交付(2026年9月)
千问 Qwen3.8-Omni-Flash 支持文本图像音频视频四类输入与 1M 上下文,官方称 29 项评测平均分提升超 25%、音频输入成本降超 98%。本文对照 Gemini 3.8 Flash 给出音频与视频两侧的强弱分野,并给出三类团队的迁移建议。



一句话结论:2026 年 9 月 18 日,阿里千问发布原生全模态模型 Qwen3.8-Omni-Flash,支持文本、图像、音频、视频四类输入与 1M 上下文,官方称 29 项评测平均分比上一代 Qwen3.5-Omni-Plus 提升超 25%,每小时音频输入成本降幅超过 98%。它的定位不是「更能听懂」,而是让音视频成为智能体可交付任务的媒介。
Qwen3.8-Omni-Flash 关键参数
- 四模态原生输入:文本、图像、音频、视频,不是语音识别 + 图像识别的拼装
- 上下文:1M token(最大输入约 99.2 万,思考模式约 98.4 万),最大输出 13.1 万
- 音频支持 113 种语言与方言,可做立体声与 4 声道空间音频分析
- 接口兼容 OpenAI 协议,支持函数调用、联网搜索、上下文缓存、三档推理强度
- 上线:阿里云百炼北京、新加坡、中国香港、东京、法兰克福、弗吉尼亚
最狠的不是分数,是价格
官方给了两个比榜单实在的数字:每小时音频输入价格降幅超 98%,每小时音视频联合输入价格降幅超 93%。计价口径是「处理 2 分钟素材成本的 30 倍」,视频按 720p、每秒 1 帧估算。阿里云国际区文本为每百万输入 token 0.15 美元、缓存输入 0.016 美元、输出 0.47 美元,中国大陆计价另有区分,以官网为准。会议转写、播客切片、长视频素材检索这类长期常驻的任务,成本结构被改写。
音视频智能体:先挑片段,再逐帧细看
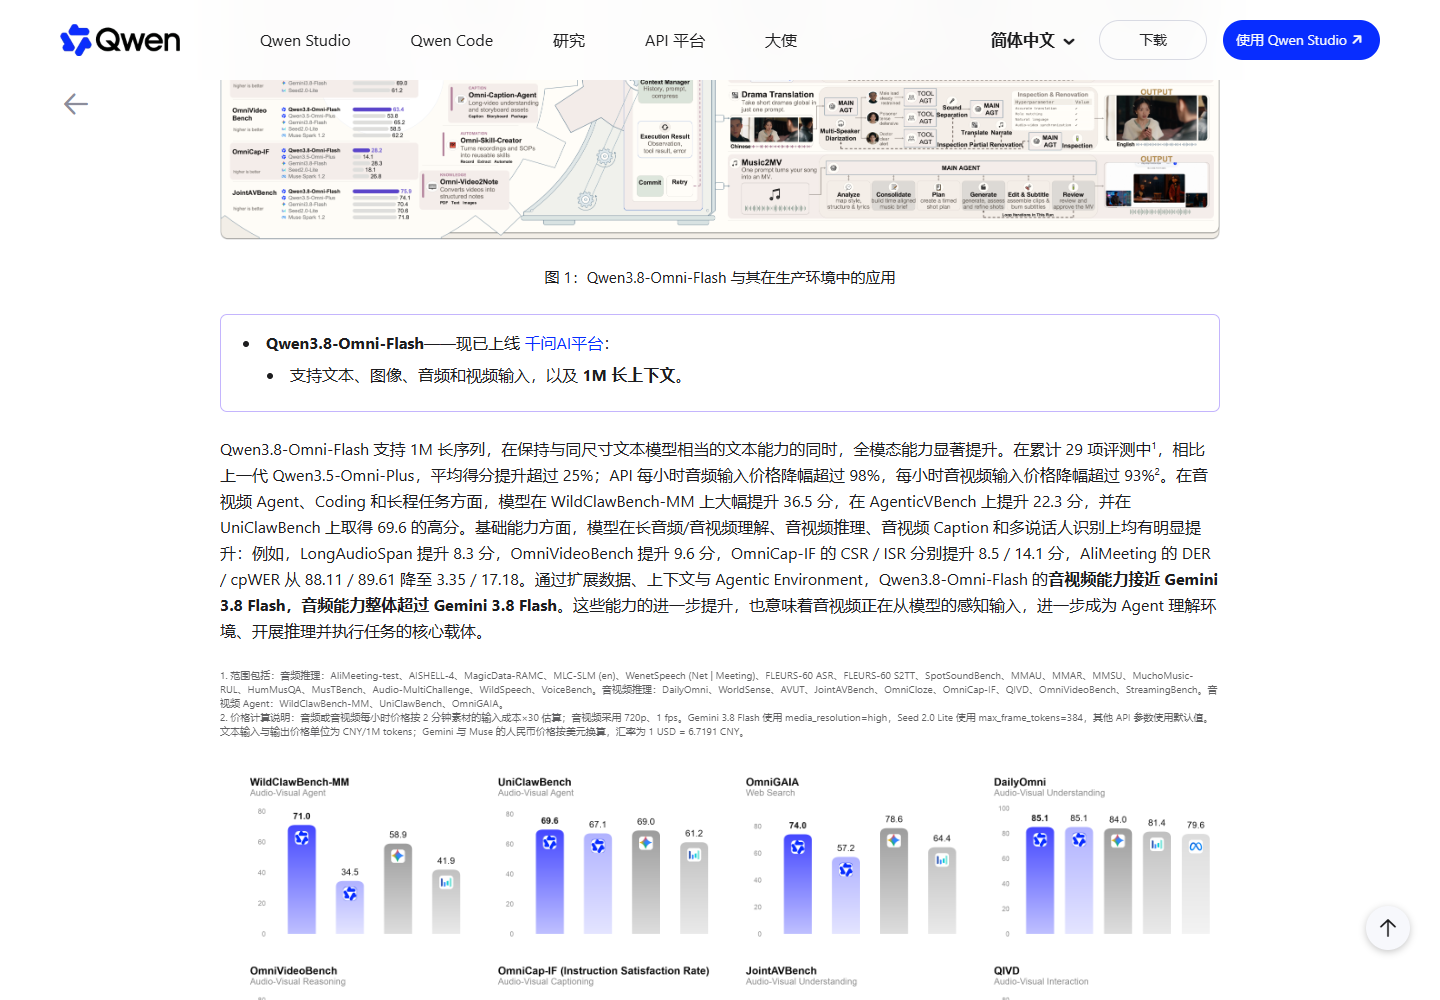
长视频的老问题是每一帧都要读一遍。这代改成问题驱动检索:先粗筛关键片段,再对候选段做多轮证据比对。官方测试里 OmniVideoBench 从 63.4 升到 67.8,单次查询 token 消耗从 145,736 降到 79,117(降 45.7%)。但同一 Agent 模式下,Gemini 3.8 Flash 在这项是 70.1,仍压一头。
同维度横评:音视频智能体该选谁
信息图:Qwen3.8-Omni-Flash、Gemini 3.8 Flash、Seed 2.0 Lite 三家在音频、音视频与成本上的同维度对比
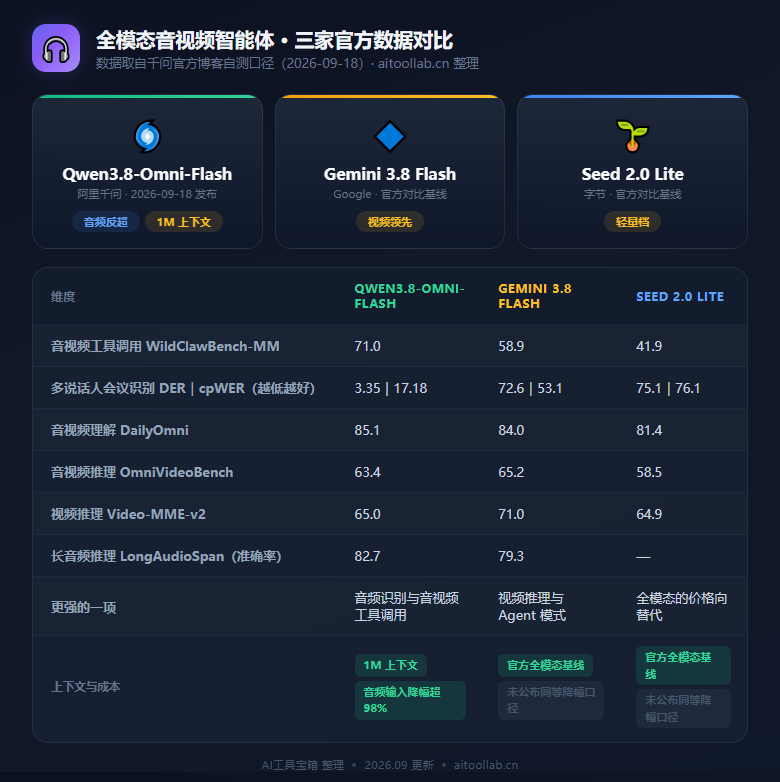
| 项目 | Qwen3.8-Omni-Flash | Gemini 3.8 Flash |
|---|---|---|
| 多说话人会议识别(DER/cpWER,越低越好) | 3.35 / 17.18 | 72.6 / 53.1 |
| 音视频工具调用 WildClawBench-MM | 71.0 | 58.9 |
| 视频理解 OmniVideoBench | 63.4 | 65.2 |
| 音视频智能体 OmniGAIA | 74.0 | 78.6 |
结论很清楚:音频与音视频工具调用千问这代反超,视频理解与视频智能体 Gemini 仍领先。官方口径说音视频「接近」、音频「整体超过」——按自家表格看,这措辞把视频侧差距说轻了。
已绑在 Gemini 上做会议转写与视频检索的团队,值得拿这组价格重谈一轮;已在用 千问 的则是顺手升级。
顺手开源了两套工具
模型本身没开源,开源的是配套:Qwen-MM-Plugins 提供多模态工具集成,适配 Claude Code、Codex、Qwen Code 与 Gemini CLI;Qwen-Live Harness 是实时音视频流的运行框架,官方称是首个支持「声音定位」的全模态实时版本,走 WebSocket 与 WebRTC。
官方还让模型自己参与研发:12 小时内完成 4 轮迭代、造出 3,413 条训练数据,把 Qwen2.5-Omni-3B 的四川方言字符错误率从 25.79% 降到 15.30%。
谁该现在试,谁可以再等
- 做会议纪要、客服质检、长视频检索的团队:98% 降幅足够覆盖迁移成本,现在就试
- 做视频理解、依赖 Gemini 视频强项的团队:先拿这组价格去谈判,别急着换栈
- 需要私有化或权重自持的团队:模型未开源,先看 Qwen3.8-Max 这类可自持路线
数据声明:本文跑分、降幅与定价取自千问官方博客(2026-09-18)与阿里云百炼文档,属厂商自测口径,以官网为准。
❓ 常见问题
模型本身没有开源,走的是阿里云百炼 API。这次开源的是配套工具:Qwen-MM-Plugins 多模态插件套件与 Qwen-Live Harness 实时运行框架。需要权重自持或私有化部署的团队,得看 Qwen3.8-Max 这类可自持路线。
官方给出的上限是最大输入约 99.2 万 token、思考模式约 98.4 万 token,最大输出 13.1 万 token,并支持上下文缓存来摊薄重复输入成本。实际可用长度还受你的素材码率与抽帧策略影响,视频按 720p、每秒 1 帧计价的估算方式就说明了这一点。
官方口径是把每小时音频的 API 价格折算成「处理 2 分钟素材成本的 30 倍」,音视频联合输入按 720p、每秒 1 帧计算,对比对象是上一代 Qwen3.5-Omni-Plus。这是厂商自测的估算方法,不是第三方测出来的账单,落地前建议用真实素材跑一批对账。
按官方自己公布的表格:多说话人会议识别、音视频工具调用、音频理解三项千问领先,视频理解 OmniVideoBench 与音视频智能体 OmniGAIA 两项 Gemini 领先。所以更准确的说法是音频侧反超、视频侧仍有差距,而不是全面胜出。