Surface Laptop Ultra 发布:128GB 统一内存把 120B 模型搬进笔记本(2026年10月)
微软 10 月 8 日凌晨发布 Surface Laptop Ultra 与 RTX Spark 平台,统一内存最高 128GB,官方称可本地运行 1200 亿参数级模型。本文拆解统一内存与显存的差别、本地跑 120B 要装哪些工具,并对比 AI PC、独显与云 API 三条路线。


北京时间 10 月 8 日凌晨,微软发布 Surface Laptop Ultra(2599 美元起)与英伟达 RTX Spark 平台:统一内存最高 128GB,官方称可本地运行 1200 亿参数级模型。
微软这次发布了什么?
Surface Laptop Ultra 厚度 18 毫米以内、重量不到 4.5 磅,散热是现款的 2.5 倍,电池模式下保留约 99% 的插电性能。
核心是 RTX Spark 超级芯片,把 Grace CPU 与 Blackwell RTX GPU 封在一起:18 核版本配 5120 个 GPU 核心、内存 24GB 或 32GB,20 核版本配 6144 个 GPU 核心、内存可选 32GB 到 128GB,FP4 算力最高 1 PFLOP。Windows 新增统一内存控制,可调整分配给 GPU 的内存。
定价 2599 美元(约 17,444 元),开发机 Dev Box 5999 美元(约 40,265 元),均已开启预订;联想、华硕、戴尔、惠普等首批机型 10 月 16 日发货。
为什么「统一内存」比「显存」更关键?
过去本地部署大模型的第一道门槛是显存:消费级独显单卡通常只有 24GB 到 32GB,模型稍大就得把权重卸载到 CPU,速度掉一个量级。
统一内存改的是这条曲线:CPU 与 GPU 共享同一内存池,128GB 可整体存放模型权重。按 4-bit 量化每参数约 0.5 字节估算,120B 权重约 60GB,加 KV Cache 与上下文大致 70GB 到 80GB,128GB 留有余量。
两点要留意:统一内存带宽低于同价位独显显存,装得下不等于跑得快;4-bit 量化有精度损失。
本地跑 120B,要装哪几件工具?
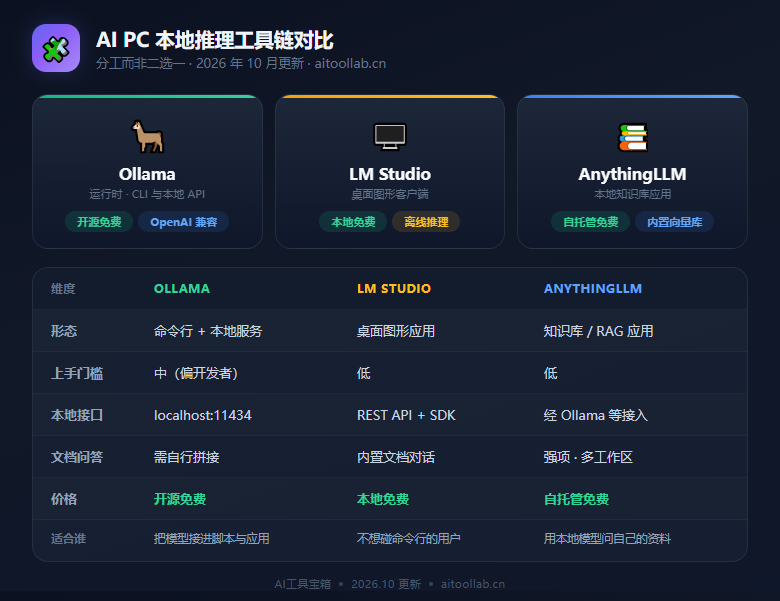
运行时用 Ollama:一条命令拉取并运行模型,自带 OpenAI 兼容的本地 API(默认 localhost:11434),开源免费,云端 Pro 每月 20 美元。
图形界面用 LM Studio:桌面应用,图形化下载与多会话聊天,提供 OpenAI 兼容 REST API 与 SDK,推理完全离线,本地免费。
上层应用用 AnythingLLM:把文档向量化成本地知识库,内置 LanceDB,可调用 Ollama 或云端模型。
要把本机变成小型推理服务,换 vLLM:PagedAttention 分页管理 KV Cache,连续批处理拉高吞吐,Apache-2.0 免费。内存吃紧又想跑大稀疏模型,可关注 colibri:纯 C 的 MoE 引擎,专家权重按需从 SSD 流式读取。
AI PC、独显工作站、云 API:怎么选?
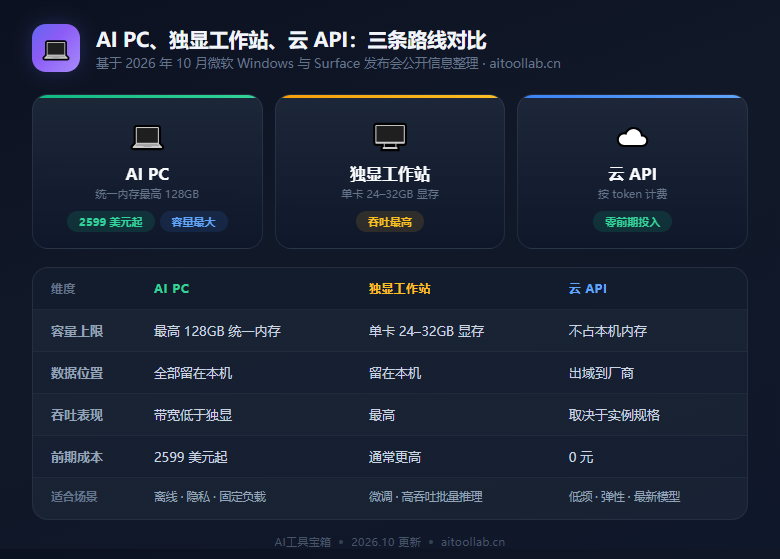
AI PC 赢容量与隐私:128GB 统一内存一次性投入 2599 美元起,模型与数据不出本机,代价是吞吐不占优;独显工作站赢速度,显存带宽高、微调更快,但单卡 24GB 到 32GB 装不下未量化的 120B 模型;云 API 赢弹性,按 token 计费、模型最新,代价是数据出域。低频与隐私优先选 AI PC,高频批处理选独显或云。
观察点:真实 token/s、Windows ML 对 llama.cpp 的接入、120B 模型在 4-bit 量化下的可用性。
Windows 侧:agent 开始常驻本机
Copilot 获得混合智能:能读取本地上下文、在许可下执行动作、自行判断用本地还是云模型,并且可整体关闭。演示里 Copilot 在本机找到报税文件、打包发给会计师,文件全程不离设备。
管理与安全同步到位:Execution Containers 转正式版,Defender 可标记恶意提示词,企业可在 Microsoft 365 统一纳管。
这些能力把 Microsoft Copilot 推向系统级执行层,也说明本地 agent 的瓶颈不是模型够不够聪明,而是内存够不够装下模型。
❓ 常见问题
Surface Laptop Ultra 定价 2599 美元(约 17,444 元),面向开发者的 Surface RTX Spark Dev Box 售价 5999 美元(约 40,265 元),两者均已开启预订。联想、华硕、戴尔、惠普等首批 RTX Spark 机型同步预售,10 月 16 日发货。
微软官方称该平台支持本地运行 1200 亿参数以上的前沿级模型。按 4-bit 量化每参数约 0.5 字节估算,120B 权重约 60GB,加上 KV Cache 与上下文开销大致 70GB 到 80GB,128GB 档位留有余量。
统一内存是 CPU 与 GPU 共享同一内存池,容量上限高,RTX Spark 机型最高 128GB,适合装下大模型;独显专用显存带宽更高、吞吐更强,但消费级单卡容量通常只有 24GB 到 32GB。前者赢容量,后者赢速度。
命令行与本地 API 用 Ollama,图形界面用 LM Studio,文档知识库用 AnythingLLM,需要高吞吐推理服务用 vLLM;内存吃紧又想跑大稀疏模型,可以关注 colibri 的 MoE 流式加载方案。
取决于调用频率。低频、偶发使用云 API 更省,没有硬件折旧;高频调用、隐私敏感或需要离线可用时,2599 美元起的一次性投入更划算,而且模型与数据都留在本机。