DeepSeek 开源昇腾训练基建:TileLang 对标 CUDA,128 卡超节点在路上(2026年10月)
DeepSeek 9月30日开源面向华为昇腾的完整训练基建:TileLang 算子语言、DeepGEMM、FlashMLA、DeepEP 与英伟达版组件一一对应,昇腾950 128卡超节点推进中,TileLang 正成为 CUDA 之外的新选择。


9月30日,DeepSeek 宣布开源面向华为昇腾平台的基础设施组件,覆盖算子编程语言 TileLang 及其编译支持、计算库和分布式通信库,并强调「所有组件与此前面向英伟达平台的开源组件一一对应」。这意味着支撑 DeepSeek V4 系列模型训练的核心工具链,如今在国产芯片上有了完整的对应版本,华为团队参与了这批组件的研发支持。
到底开源了哪些组件?
这次开放的是模型训练「跑起来」的三个关键环节:
- TileLang:算子编程语言,昇腾版封装了底层 Ascend C 指令,开发者用更高级的语言写程序,不必直接碰芯片指令;
- 计算库:DeepGEMM 加速矩阵运算,TileKernels 覆盖向量计算与访存,FlashMLA 负责稀疏注意力以提升长上下文效率,DeepSelect 用于高效筛选数据;
- DeepEP(昇腾版):分布式通信库,负责混合专家模型(MoE)里数据在不同专家网络之间的分发与汇合。
复用性是这次开源的亮点:TileKernels 支持同一套 Python 接口在英伟达 GPU 与华为 NPU 上运行,底层实现按硬件自动选择;DeepEP 的公开接口与英伟达版本对齐,开发者沿用已有调用方式即可切换。
FlashMLA 在昇腾 950 上跑到多快?
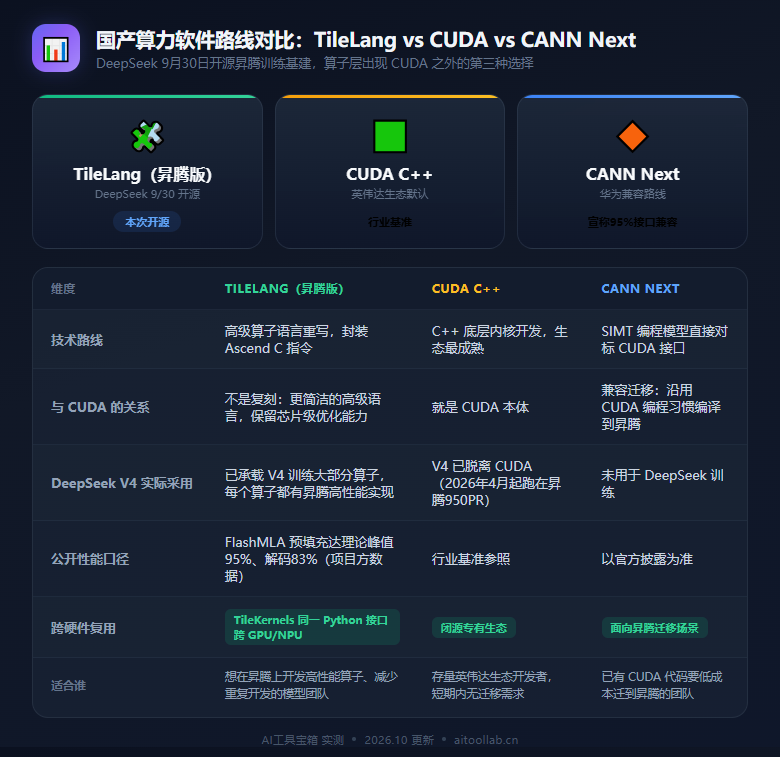
按项目文档公布的成绩:在昇腾 950 上,处理输入上下文的预填充阶段,稀疏注意力算子最高达到硬件理论峰值的 95%;逐步生成内容的解码阶段,最高达到 83%。数据声明:这两项均为项目方公布的测试结果,暂无独立第三方复核,实际收益请以自测为准。DeepSeek 同时强调,这种简化「不会损失硬件性能」——目前其训练中用到的每一个 TileLang 算子,都已有对应的昇腾高性能实现。
128 卡超节点和 16 万颗芯片意味着什么?
官方披露,DeepSeek 与华为正在共同推进基于昇腾 950 的 128 卡超节点方案,对计算和通信进行深度优化。另据 aibriefing 报道,DeepSeek 计划在内蒙古部署超过 16 万颗华为加速器。若如期落地,这将是全球最大规模的「去英伟达」训练集群之一——大模型训练从「单卡性能竞赛」进入「集群工程竞赛」,通信库和超节点设计的重要性不亚于芯片本身。
TileLang 能替代 CUDA 吗?
现在下结论为时过早,但路线已经清晰。TileLang 的定位是「比 CUDA 简化代码、提高开发效率,同时保留针对芯片特性优化的能力」,这条路线先在英伟达平台验证,如今已承载 V4 系列训练中的大部分算子。需要冷静看待的是:接口能复用不等于性能天然对齐,迁移后仍需针对硬件打磨;CUDA 十余年积累的调试工具、性能分析器和社区库,也不是一个算子语言短期内能补齐的。
值得一提的是,华为另一条 CANN Next 路线走「兼容路线」,宣称实现 95% 以上 CUDA 接口兼容;DeepSeek 的 TileLang 路线则是「高级语言重写」。两条路线殊途同归——都在给开发者提供 CUDA 之外的选项。这条路线能走多远,最终看昇腾集群上跑出来的真实训练效率。
三条国产算力软件路线的关键差异,见下方信息图。
对开发者意味着什么?
对运行自己模型的团队,这批组件可以直接复用:矩阵运算、访存、稀疏注意力、跨卡通信的常见实现都开源了,不必逐项从头优化。对依赖 硅基流动 等 API 平台调用 DeepSeek 模型的用户,短期内无感,但中长期看,训练成本下降会传导到 API 定价;海外开发者也可以通过 OpenRouter 或 Hugging Face 关注这批组件的后续社区版本。算子层的开源竞赛,才刚刚开始。
❓ 常见问题
面向华为昇腾平台的基础设施组件,包括 TileLang 算子编程语言及编译支持、DeepGEMM、TileKernels、FlashMLA、DeepSelect 计算库和 DeepEP 分布式通信库,与此前面向英伟达平台的开源组件一一对应。
TileLang 不是 CUDA 的复刻,而是更高级的算子编程语言:比 CUDA 简化代码、提高开发效率,同时保留针对芯片特性优化的能力,目前已承载 DeepSeek V4 训练中的大部分算子实现。
项目方公布的口径为:FlashMLA 稀疏注意力算子预填充阶段最高达硬件理论峰值 95%、解码阶段最高 83%。这两项均为项目方测试成绩,暂无独立第三方复核。
组件开源后可直接复用于昇腾平台的模型开发与部署;TileKernels 支持同一套 Python 接口跨英伟达 GPU 与华为 NPU 运行。不自己管算子的开发者可继续通过 API 平台使用 DeepSeek 模型,成本变化需观察后续定价。