AI 智能体开始自己修 Bug:SelfSearch 4 美元追上 Codex,三条自我进化路线(2026年10月)
2026 年 10 月 AI 智能体集体转向「自我进化」:SelfSearch 用 4.03 美元搜索出追平 Codex 的 harness,ContextQA Ship 把 Bug 复现交给 AI,Meta 把准确率从 45.8% 提到 62.5%,Hugging Face 把编码 harness 改成 RL 环境。



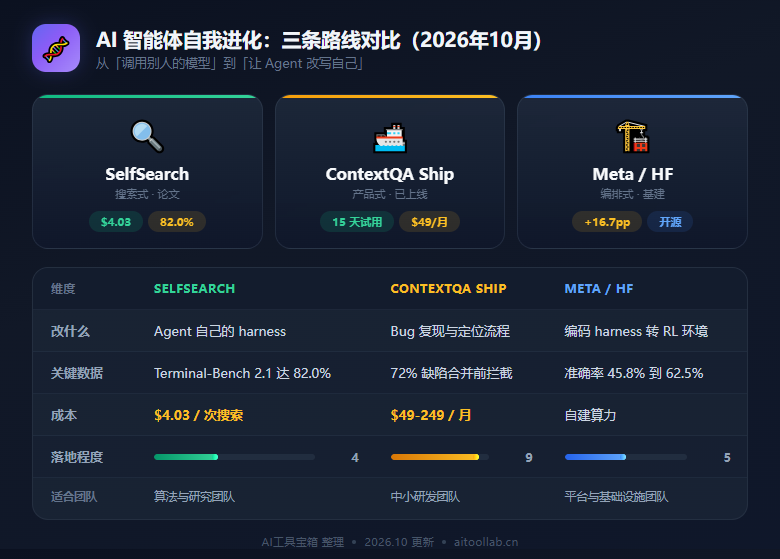
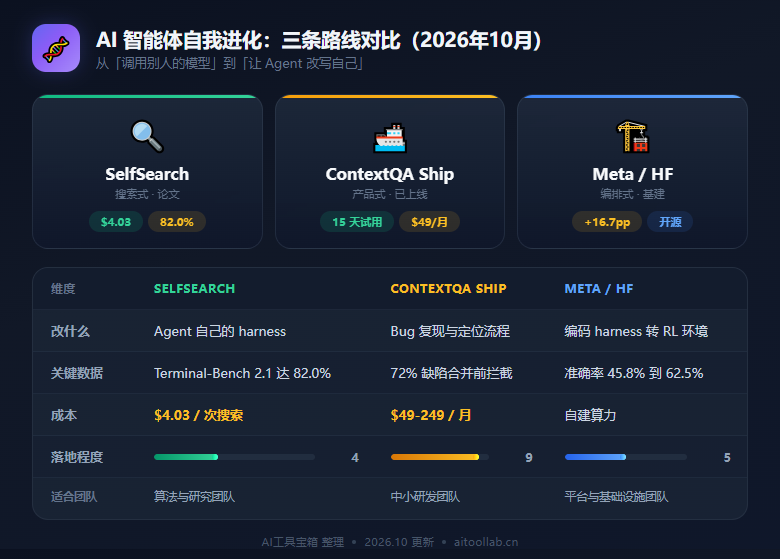
2026 年 10 月,AI 智能体出现了一个共同方向:Agent 开始改写自己。SelfSearch 用 4.03 美元搜索出的 harness,让 DeepSeek V4 Flash 在 Terminal-Bench 2.1 上拿到 82.0%,追平榜首的 Codex;ContextQA 上线自主质量工程师 Ship,从 Slack、Jira、Linear 接 Bug 并把根因交给 Claude 或 Codex;Meta 用 RankEvolve 把执行准确率从 45.8% 提到 62.5%;Hugging Face 则把主流编码 harness 改造成了强化学习环境。竞争重心正从「谁的模型更强」转向「谁能让 Agent 自己变强」。
为什么「自己修自己」在 2026 年 10 月集中爆发?
过去优化 Agent 靠人工改提示词、换工具、重排流程,迭代慢且难复现。当编码能力足够强,Agent 就有了「读自己的代码、改自己的流程」的前提:它能检查并修改自身的指令、工具与执行步骤。优化对象于是从模型权重换成 harness(智能体外壳),搜索空间从「任务答案」换成「自我改进记录」。
SelfSearch:4.03 美元、82.0% 准确率,省掉的是什么?
SelfSearch 的核心是「无奖励搜索」。常规做法每轮修改后都要跑下游评测拿分数,成本高且搜索被绑死在特定任务上。SelfSearch 改用过往自我改进过程的记录——推理链、工具调用与修改结果——来指导下一轮修改,全程不需要下游奖励信号。六个模型-基准组合的群体平均成功率全部提升,单个 Agent 在 Terminal-Bench 2.1 上最多提升 11.2 个百分点;SWE-bench Multilingual 上成功率提升 5.0 个百分点,执行成本下降 38.5%。
ContextQA Ship:把「复现 Bug」这一步交给 AI
SelfSearch 是研究路线,Ship 是产品路线。它接住 Linear、Jira、Slack 里的 Bug,自动复现、给出疑似根因,再把复现步骤和修复建议交接给 Claude Code 或 Codex CLI。官方数据:72% 的回归缺陷在合并前被拦截,变更到测试的覆盖率 94%,Bug 解决时间缩短 68%,每版本质量成本下降 43%。计费按 credit,15 天试用含 3000 credits,Starter 每月 49 美元、Pro 每月 249 美元。
Hugging Face 与 Meta:把 harness 变成可训练的环境
基础设施层同步推进。Hugging Face 把主流编码 harness 转成强化学习环境,不需要改动 harness 本身或训练代码,覆盖 Claude Code、Codex 等。Meta 用 RankEvolve 多智能体框架配合分支式 harness 自优化,把执行准确率从 45.8% 拉到 62.5%。微软的 ActiveSaddler 则按「尚未修复的失败」挑选任务来优化 Agent。
三条路线怎么选,现在能用什么?
算法与研究团队优先复现 SelfSearch 这类无奖励搜索,但重点要验证它能否迁移到自己的任务分布。中小研发团队更适合 Ship 这类产品化方案,按 credit 计费、15 天试用,可以先在一个仓库上验证「Bug 复现」能省多少人力。平台团队值得投入的是把内部 harness 接进 RL 环境。
落地工具上,Claude Code 与 Codex CLI 是 Ship 交接修复线索的两个默认目标,也是当前 harness 生态的中心;OpenAI Codex Harness 可直接对照 SelfSearch 的对比口径;Aider 适合把「改代码」这一步脚本化。
数据说明
数据来自 SelfSearch 论文(arXiv:2609.37968)、ContextQA Ship 官方页面与 2026-10-04 至 10-06 的行业速报。基准成绩为各团队自报口径,横向对比仅供参考。
❓ 常见问题
这 4.03 美元是搜索过程中消耗的模型调用成本,不含后续跑基准评测的开销。SelfSearch 的关键在于搜索阶段不需要下游奖励信号,只靠过往自我改进的记录来指导下一轮修改,所以能用极低的成本搜出一个 harness。在公开的九款 harness 对比设置下,这个 harness 让 DeepSeek V4 Flash 解决 82.0% 的 Terminal-Bench 2.1 任务,追平榜首的 Codex。
不需要。Ship 的设计是接入团队已有的工具链:代码与 CI 继续留在 GitHub,Bug 继续留在 Linear 或 Jira,沟通继续在 Slack,Ship 只是在中间接住质量工作。它支持从 Linear、Jira、Slack 和服务台读取 Bug,自动复现并给出疑似根因,再把复现步骤、会话回放和修复建议交接给 Claude Code 或 Codex CLI。
可以直接用上的是产品化路线。ContextQA Ship 提供 15 天免费试用,含 3000 credits,Starter 每月 49 美元,适合先在一个仓库上验证 Bug 复现能省多少人力。SelfSearch 目前是论文成果,需要自己复现搜索流程,更适合算法与研究团队。把内部 harness 接进强化学习环境属于平台级投入,短期看不到直接收益。
主要风险是缺乏外部校验。SelfSearch 用的是无奖励搜索,搜索阶段没有下游评测把关,这意味着搜出来的 harness 可能在训练分布上表现好、换到真实任务上就退化。实践上应当把自我改进限制在可回滚的外壳层,保留人工审查与回归测试,并且像 ContextQA 那样把 72% 的回归缺陷拦截在合并之前,而不是等到生产环境才发现问题。