谷歌 Gemini 4 Argon 发布:单次输出 100 万 token,$2/$10 半价硬刚 Opus 5.5
谷歌 9 月 30 日发布 Gemini 4 世代首款旗舰 Gemini 4 Argon:单次输出 100 万 token、2/10 美元定价仅 Opus 5.5 一半,知识工作基准四款模型第一,但首发只给网络安全防御者,普通开发者暂不可用。


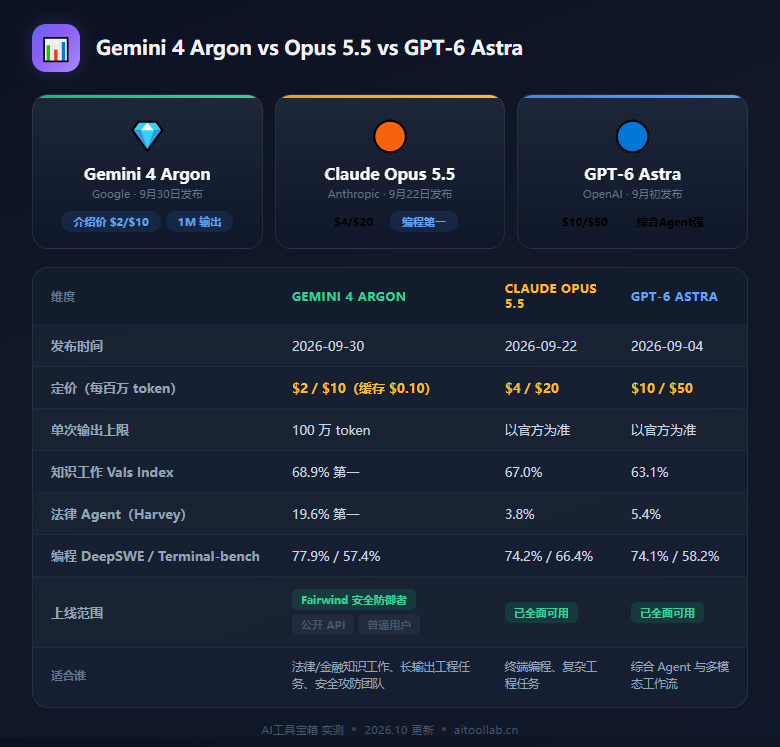
9 月 30 日,Google DeepMind 发布 Gemini 4 世代首款旗舰模型 Gemini 4 Argon。三个数字先记住:单次输出上限从 64K 拉到 100 万 token;输入 2 美元、输出 10 美元每百万 token,只有 Claude Opus 5.5 的一半、GPT-6 Astra 的五分之一;知识工作基准 Vals Index 68.9%,四款对比模型里最高。但你现在用不到它:首发只开放给 Fairwind Program 的网络安全防御者,付费 API 客户排第二批,官方没给日期。
知识工作第一次压过 Opus 5.5:法律基准超过对手总和
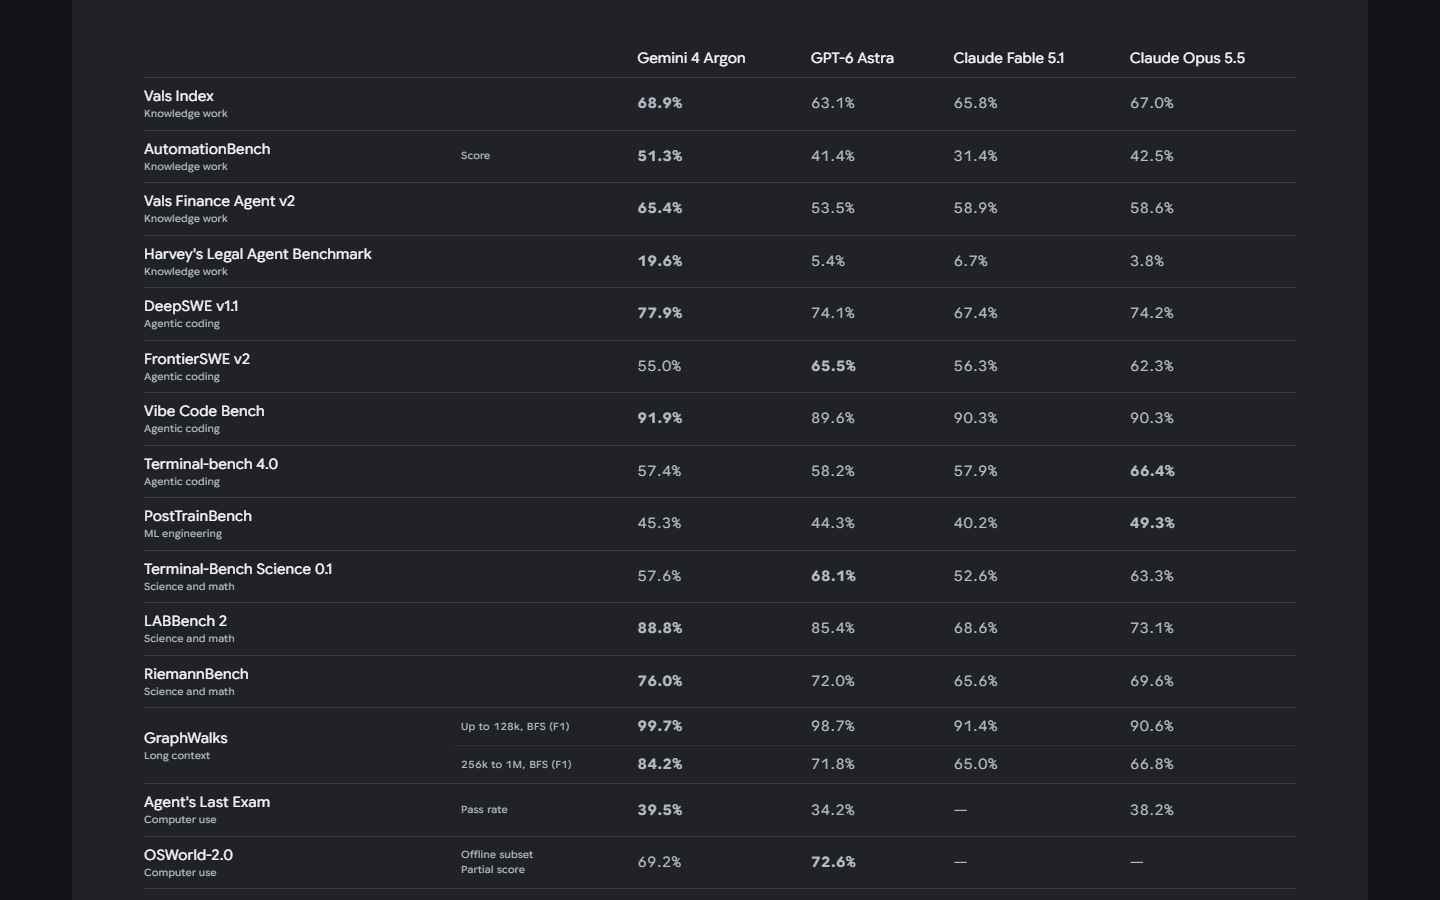
这份由首席 AI 架构师 Koray Kavukcuoglu 签发的官方成绩单里,最能说明定位的是知识工作三项:Vals Index 68.9%(Opus 5.5 为 67.0%、GPT-6 Astra 63.1%)、AutomationBench 51.3%(三家为 42.5%/41.4%/31.4%)、Harvey 法律 Agent 基准 19.6%——同表里 Astra 5.4%、Claude Fable 5.1 为 6.7%、Opus 5.5 仅 3.8%,Argon 一项超过三家总和。长上下文同样领先:GraphWalks 256K-1M 档 F1 84.2%。Google 给它的定位很直白:真实世界的软件工程、法律与金融知识工作、网络安全防御。
编程不是全能冠军:两项基准仍输给对手
编程侧 Argon 拿下 DeepSWE v1.1 77.9% 第一,但 FrontierSWE v2 只有 55.0%(Astra 65.5%)、Terminal-bench 4.0 为 57.4%(Opus 5.5 达 66.4%)。100 万 token 输出的意义在这里:代码迁移、全库重构这类一次要吐几万行结果的长任务,不再被 64K 输出截断。预算敏感的团队也可以对照 DeepSeek 与 Kimi 的开源路线自行权衡。
2 美元/10 美元:把旗舰价格打到五分之一
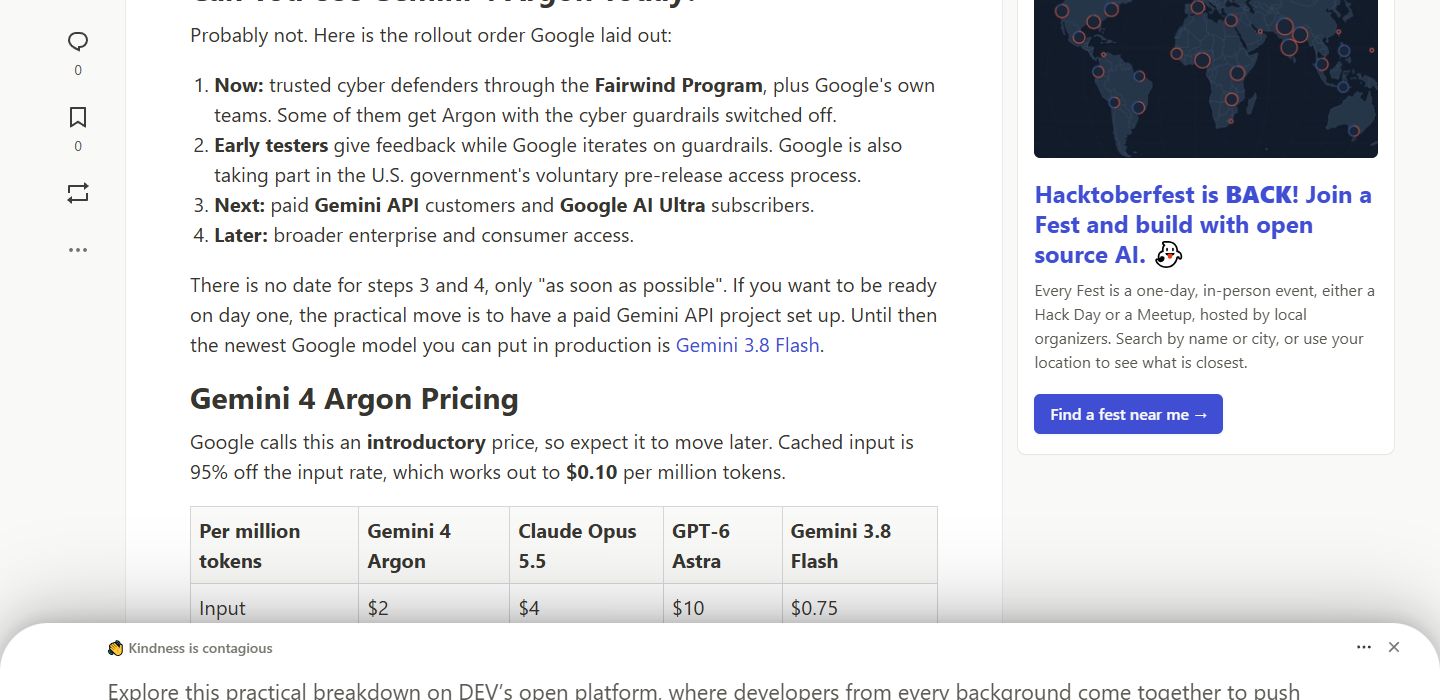
定价:Argon 输入 2 美元、输出 10 美元,缓存输入 0.10 美元(95% 折扣);Opus 5.5 为 4/20 美元;GPT-6 Astra 为 10/50 美元。算一笔账:100 万输入加 20 万输出的任务,Argon 花 4 美元、Opus 5.5 花 8 美元、Astra 花 20 美元。注意 Google 自己称这是「介绍价」,后续会调。这套打法延续了 9 月以来 Claude 与 GPT 的降价节奏——旗舰能力、中档价格。
为什么先发给网络安全防御者
这次发布节奏罕见:第一批用户是 Fairwind Program 里的可信安全防御团队,部分版本甚至关闭安全护栏用于攻防演练,Google 同时参与美国政府的自愿预发布流程。安全特性上,官方称 Argon 是对抗间接提示注入最有韧性的模型,并部署了思维链监控、沙箱加固与对齐缓解措施;CWE-bench v1 网络安全基准 68.0%,与 Astra 并列第一。付费 API 客户与 Google AI Ultra 订阅者是第二批,企业与个人消费者「尽快」,均无日期。想先用上最新 Google 模型的,当下仍只有 Gemini 3.8 Flash。
三款旗舰模型关键维度对比信息图
给开发者的三个动作
一、提前建好付费 Gemini API 项目,第二批开放当天即可接入;二、长输出场景(迁移、批量重构、长文档生成)把 Argon 列入选型观察项;三、本文跑分全部取自 Google 官方 methodology 页,第三方复测尚未出现,选型判断以官方数据与自行实测为准。
❓ 常见问题
暂时不能。首发只开放给 Fairwind Program 里的可信网络安全防御团队和 Google 内部团队;第二批是付费 Gemini API 客户与 Google AI Ultra 订阅者,企业与个人消费者更晚,官方未公布具体日期。
介绍价为每百万 token 输入 2 美元、输出 10 美元,缓存输入 0.10 美元(约 95% 折扣),约为 Claude Opus 5.5(4/20 美元)的一半、GPT-6 Astra(10/50 美元)的五分之一。Google 明确这是介绍价,后续可能调整。
此前旗舰模型输出上限多为 64K,长任务(代码迁移、全库重构、超长文档生成)会被截断成多段。Argon 把上限拉到 100 万 token,一次任务可以完整交付几万行级别的结果,官方称专为长程多步工作设计。
分场景。知识工作(Vals Index 68.9%、Harvey 法律基准 19.6%)与 DeepSWE 编程(77.9%)第一;但 Terminal-bench 4.0 落后 Opus 5.5(57.4% 对 66.4%)、FrontierSWE v2 落后 GPT-6 Astra(55.0% 对 65.5%),数学科学两项也各有胜负。所有跑分取自 Google 官方页,第三方复测未出。