Momentic Mo 正式发布:AI 找 Bug 是 Codex 的 3.1 倍,测试赛道开始按真 bug 计分
Momentic 的 AI QA 工程师 Mo 正式可用,QA Bench 实测找到 269 个 bug、是 Codex 的 3.1 倍。本文拆解测试方法、成本账与 mabl、Testsigma、Autify 的分工。


2026 年 11 月,Momentic 宣布其 AI QA 工程师 Mo 正式可用:给它一个网址和一段简报,它会自己规划、探索应用、批量找 bug;功能类 bug 先由独立智能体复现才上报。同期公布的 QA Bench 显示:在 4 个开源应用、1396 个人工标注 bug、每区 60 分钟的统一考场,Mo 平均找到 269.3 个,是第二名 Codex(GPT-6.1 Sol 加 Playwright MCP,86.3 个)的 3.1 倍——代价是单 bug 成本 2.67 美元,约为对方的 3.3 倍。测试赛道第一次有了按「找到的真 bug」计分的横评。
编码智能体跑得越快,验证欠的账越多
Momentic 在官网说得很直白:编码智能体让造软件更快,瓶颈变成了确认它真的能用。这家 2023 年成立的公司挂出累计数字:117,010 个被拦在上线前的 bug、7060 万次测试执行、80,290 个被验证的 PR、893 万次自动修复;客户包括 Notion、Quora、Runway,其中 Quora 把每日测试从 7 小时压到 30 分钟、替换 500 多条手工用例。
Mo 不是录制回放工具,而是探索式测试员:给它目标和一段简报,它输出报告,写清验证了什么、哪些没验证到。这补的正是 Claude Code、OpenAI Codex 这类编码智能体写完代码之后、合并之前的那段空档。
QA Bench:1396 个真 bug 的同卷考试
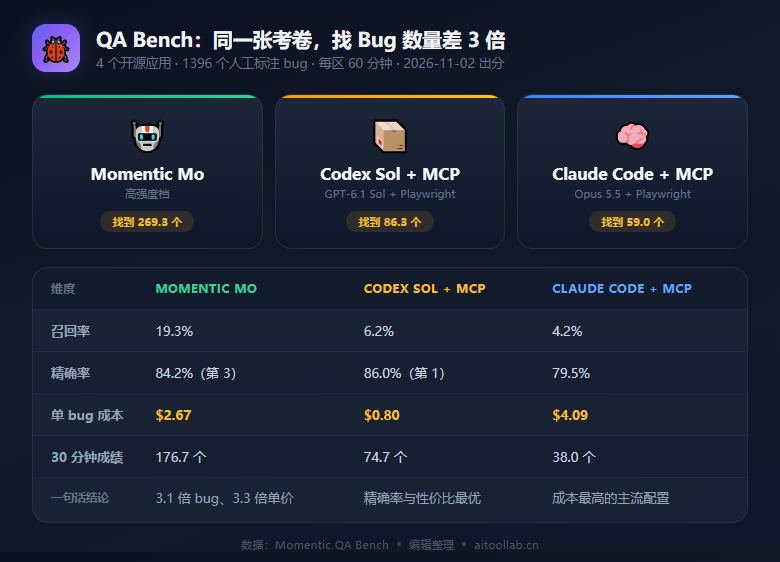
考题是 Gitea、Metabase、Twenty、Saleor 四个开源应用里的 1396 个人工标注 bug,覆盖 20 个产品区。每个智能体在独立沙箱一次测一个区,简报时限相同(30/60 分钟),不许读源码和标注;除 Devin 只跑一次外,各配置取三次均值,2026-11-02 出分。
最扎眼的三行:Mo 高强度档找到 269.3 个、召回率 19.3%;最强的 Codex 配置 86.3 个、6.2%;Claude Code(Opus 5.5 加 Playwright MCP)59.0 个、4.2%。但要盯着另两列读:精确率最高的是 Codex Sol(86.0%),Mo 的 84.2% 只排第三;单 bug 成本上 Codex Terra 配置低至 0.27 美元,Mo 是 2.67 美元。官方总结是「3.1 倍的 bug,3.3 倍的单价」——Mo 赢在量,性价比优势仍在 Codex 手里。
Mo 上岗方式:四个智能体,各管一段
Mo 会话里有四类角色:会话智能体规划覆盖面、派活、去重;探索智能体画产品地图,只报嫌疑不确认;找 bug 智能体在自己的浏览器里逐条排查;复现智能体拿到嫌疑后从干净起点独立走一遍,复现不出来就不算确认的功能 bug。各子智能体用独立的浏览器或模拟器,并行开工。
入口有四个:编码智能体、网页端、PR 评论、qa 命令行;目标支持网页应用、iOS 模拟器和 Android 仿真器。边界:系统对话框(打印、mailto)会卡住验证,一次会话只测一个目标。
和 mabl、Testsigma、Autify 怎么分工
Mo 解决的是找新 bug,库内几款测试工具解决的是守住旧功能。mabl 按云执行 credits 计费,主打测试与 CI 的原生集成;Testsigma 用自然语言写用例、云执行分钟数不限;Autify 14 天试用、移动版 199 美元/月起,强项是移动端自动化和测试自愈。三者思路相同:把关键流程固化成用例,每次发布跑一遍。
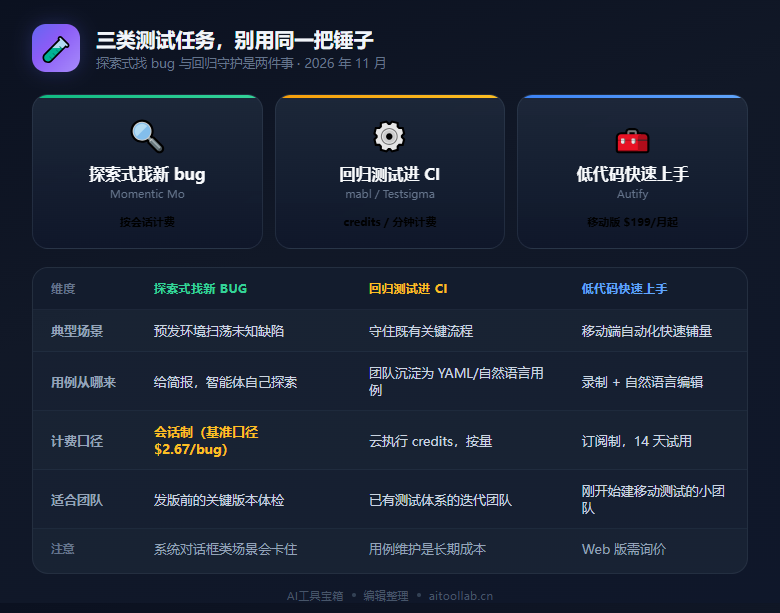
务实组合是两段式:发布前用 Mo 对预发环境做探索扫荡,抓没见过的 bug;日常迭代用回归工具守住既有流程。刚建测试体系的团队先补回归底子,再在关键版本引入探索式智能体。
数据说明:本文数据来自 Momentic 官方 QA Bench(2026-11-02 出分)、Mo 文档与官网。QA Bench 由 Momentic 发布、Mo 为其自家产品,属厂商自评基准;标注与计分规则公开(数据在 Hugging Face),横向解读仍需谨慎。成本按牌价加 Browserbase 时长估算,Mo 按会话计费。
❓ 常见问题
Mo 是 Momentic 推出的 AI QA 工程师,2026 年 11 月正式可用。给它一个应用地址和一段测试简报,它会自动规划覆盖面、探索应用、批量查找 bug 并输出带证据的报告;功能类 bug 会先由独立的复现智能体验证后才确认上报。
QA Bench 由 Momentic 发布,Mo 是其自家产品,属于厂商自评基准。但方法相对透明:1396 个人工标注 bug、4 个开源应用、统一时限与简报、禁止读源码和标注,标注数据公开托管在 Hugging Face,第三方可以复核。
官网可免费注册开始使用,无需信用卡;QA Bench 口径下 Mo 按会话计费,60 分钟高强度档约合每个 bug 2.67 美元。公开的价目表尚未发布,企业版(SSO、审计日志、专属支持)需联系销售。
不能完全取代。系统级对话框(打印、mailto)等场景会卡住验证,报告会明确列出未验证到的覆盖缺口;一次会话只测一个目标。它更适合承担重复性的探索扫荡和回归验证,把人工 QA 释放给测试策略和边界场景设计。
两者解决的问题不同:mabl、Testsigma、Autify 把已知关键流程固化成用例反复执行,守住旧功能;Mo 是探索式测试,负责在发布前发现没见过的 bug。常见组合是回归工具打底、关键版本前用 Mo 做一轮探索式扫荡。