Revolut 把 2000 名工程师的默认模型换成自托管 GLM:账单降到十分之一
欧洲金融科技独角兽 Revolut 把约 2000 名工程师的默认编码模型换成自托管 GLM 5.3:56 张 B200,混合成本约 0.3 美元/百万 token,账单约为原来的十分之一。数字均为自报,本文拆解哪些能抄、哪些要打折。



欧洲最大金融科技独角兽 Revolut 把约 2000 名工程师的默认编码模型换成了自托管的开源 GLM。其 AI 运营负责人 David Abitbol 在 AI Engineer 纽约站披露:2026 年 4 月先切到 GLM 5.1,现在由 56 张英伟达 B200 支撑约 2000 人日常编码,混合成本约 0.3 美元/百万 token,账单约为此前旗舰 API 方案的十分之一;Claude Code 与 Codex 没有被扔掉,而是退居「例外」档。演讲 10 月 13 日落地,11 月 2 日起在 X 上病毒式传播。先说折扣:账单与效率数字全是 Revolut 自报,未做归因分离。
一场旧演讲,为什么这两天炸了
这场 15 分钟的分享题为《Shipping like a startup, regulated like a bank》,原本不温不火,11 月 2 日起被英文技术圈重新翻出:两条热门转述帖合计超过 50 万浏览,中文圈随后跟进。转述走样最快的是模型版本——有说 GLM 4.5、有说 5.1,核对演讲页与逐字稿才能确认:2026 年 4 月切换的是 GLM 5.1,如今服务 2000 人的已是 GLM 5.3。另一处常被省略的背景是:此前 Revolut 给每位工程师的 Claude Code 额度是每人每月 300 美元,而对整体效率的帮助有限——这正是他们转向自托管开放权重的起点。
数字要打折:1/10 与 70% 都不能照抄
演讲页自己写明,0.3 美元/百万 token 描述的是 Revolut 的部署与利用率,不是自托管模型的通用价格;约 60%—70% 的效率提升也没有把模型切换与同期其他变化(放开 token 限额、推理调优)分开归因。还有一笔常被漏掉的账:56 张 B200 的采购与运维、团队人力,都不在这「十分之一」里。
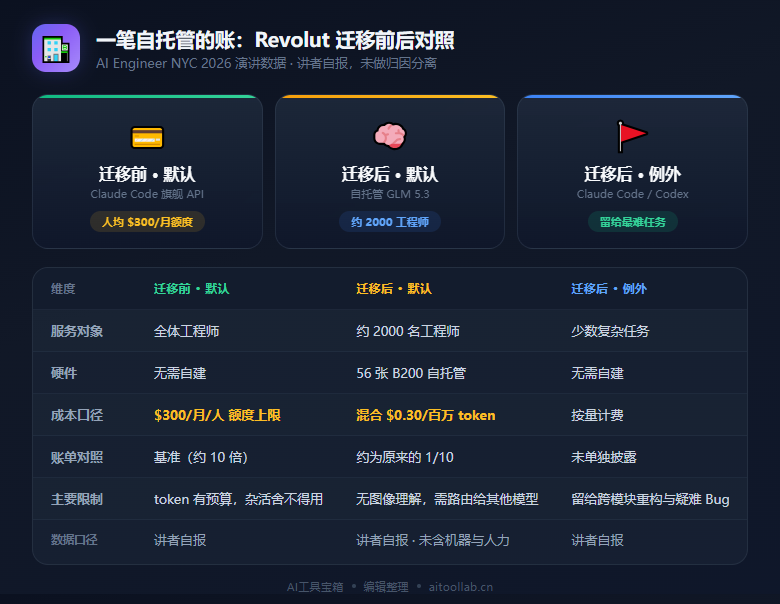
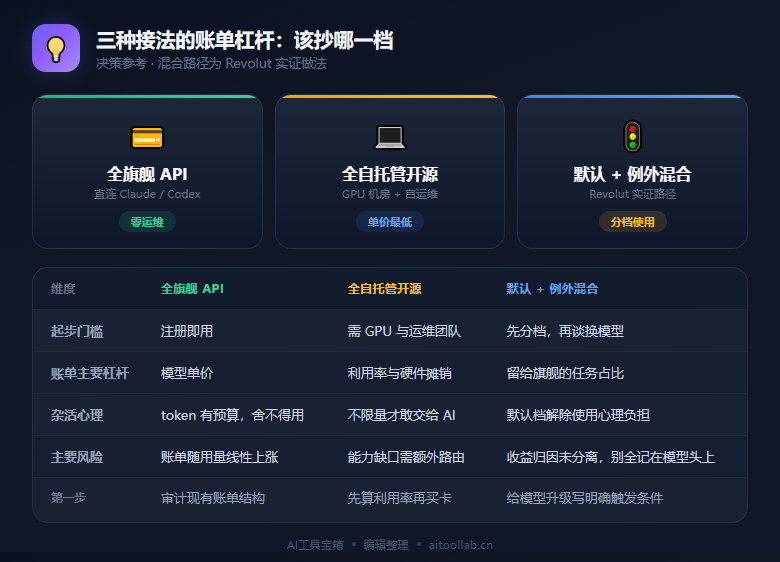
全篇最值钱的反而是个软发现:lead time 的改善幅度大于纯写代码时长。Abitbol 的解释是,工程瓶颈本就不全在写代码,还有翻邮件、整理 Jira 与文档;token 有预算时工程师舍不得,只把额度留给最难的活,不限量之后这些杂活也敢交给 AI 了。账单的主要杠杆因此不是单价,而是「多少活留给旗舰」。
真正能抄的是分档,不是机房
56 张 B200 大多数团队抄不了,但分档方法可以照搬:日常改字段、补测试、读文档、整理工单交给便宜或自托管模型;跨模块重构、疑难 Bug、架构与安全决策留给旗舰。配套三件事——给升级定明确触发条件(如默认档在同一处连续失败两次就升级);先定延迟预算再谈模型(他们要求首 token 3 秒内,超 5 秒就有人投诉);上下文开 256K 即可(Abitbol 原话「长上下文是骗局」),编码场景缓存命中率要做到 90% 以上。
自托管侧的细节:部署走 vLLM 一类推理框架,吞吐 200 token/秒就够——工程师习惯并行开几个任务、做完回来看;GLM 5.3 无图像理解,用一个本地路由把图片请求转给其他模型,分工不只按难度,也按能力。沙箱白名单细到具体动作:允许 grep,不允许 gradle。
银行为什么敢这么用
合规是后半段的主线:权重下载后放在美国、欧盟、英国等数据等效地区的 GPU 上,不走去中国的推理接口;服务商默认零数据留存;编码任务全部在沙箱里、人始终在环,因此监管不把它当「自主智能体」;再配上完整遥测,出事可追溯。演讲页特别声明这些判断只适用 Revolut 自身处境,不能当作其他公司的合规结论。另一条反方信息值得记下:有英文帖引用第三方评测称 GLM 5.3 明显低于最强闭源模型(榜单未核实)——「例外通道」必须留着,便宜模型不是平替。
数据说明:本文事实来自 AI Engineer 纽约站演讲页与逐字稿,并经 X 热帖与多家媒体转述交叉核对;0.3 美元/百万 token、约 1/10 账单及效率提升均为讲者自报口径,演讲页明确未将模型切换与其他工程变化分开归因,且未计入硬件与人力成本。
❓ 常见问题
没有。Claude Code 与 Codex 保留为「例外」档,处理跨模块重构、疑难 Bug 等难任务,变化是角色从默认变成例外,而非弃用。
不是。演讲页明确该数字描述 Revolut 自己的部署与利用率,不含硬件采购与人力成本,其他团队照搬大概率不成立。
Revolut 用 56 张英伟达 B200 服务约 2000 名工程师。小团队不必照搬硬件,建议先按「默认档+例外档」分档,再评估是否值得自托管。
Abitbol 认为编码场景 256K 上下文就够用,盲目堆超长上下文利用率很低;编码场景真正的杠杆是把缓存命中率做到 90% 以上。
先把任务分成日常档与难任务档并写明升级触发条件,审计现有 AI 编码账单结构,再决定是否需要自托管;有合规要求先问合规团队。