阶跃 Step 5 Preview:600B 只激活 27B、AA 44 分开源前三,10月15日开源
阶跃星辰9月20日发布旗舰基座模型Step 5 Preview:稀疏MoE总参600B、激活仅27B,100万Token上下文,原生文本加视觉输入,在Artificial Analysis智能指数拿到44分位列全球开源前三,官方称单任务成本仅Claude Opus 5的1/8,并宣布10月15日正式开源权重。本文解析稀疏MoE的效率逻辑、44分的含金量以及开发者现在能用什么。


9月20日,阶跃星辰发布新一代旗舰基座模型 Step 5 Preview:稀疏 MoE 架构,总参数量 600B、激活参数仅 27B,支持 100 万 Token 上下文窗口,原生支持文本与视觉输入,面向 AI 编程、软件工程、专业知识工作与金融场景。在 Artificial Analysis 综合智能指数(AA Intelligence Index)中它拿到 44 分,跻身全球开源模型前三;官方口径下,单任务成本仅为 Claude Opus 5 的 1/8,并宣布 10 月 15 日正式开放模型权重。本文数据来自阶跃星辰官方发布与 Artificial Analysis 榜单,经环球网、每日经济新闻、澎湃新闻等多源交叉核实,以官方公告为准。
为什么「只激活 27B」是关键?
智能体(Agent)时代,成本大头在推理侧:任务越长、工具调用越多,token 消耗越猛。稀疏 MoE 的思路是让 600B 参数撑起能力上限,但每个 token 只激活 27B 参数来控制单次计算成本。阶跃对此的表述很直接:下一阶段模型 Scaling 的核心,是提高「计算转化为智能」的效率,而不是继续堆算力换能力。从 2 月的 Step 3.5 Flash、5 月的 Step 3.7 Flash 到这次的 Step 5 Preview,连续三代模型都围绕这条效率主线迭代。
44 分的含金量:和谁比?
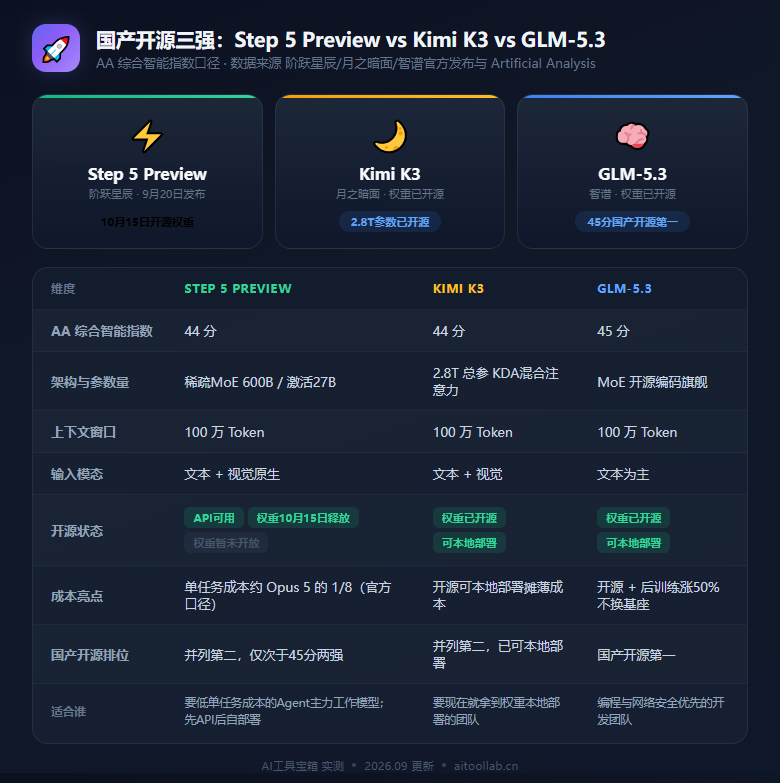
最新的 AA 综合智能指数 v4.3 由 AA-Briefcase、Terminal-Bench 4.0、SciCode 等 10 项评测构成。Step 5 Preview 拿到 44 分,与总参数量 2.8 万亿的 Kimi K3 同分——用的体量不到其五分之一;在国产模型中,仅次于 45 分的 Qwen3.8-Max 与 智谱 GLM-5.3。对照闭源侧,其单任务成本按官方口径仅为 Claude Opus 5 的 1/8,走的正是「同等成本换更强智能」的帕累托前沿路线。
信息图:Step 5 Preview 与 Kimi K3、GLM-5.3 三款国产开源模型对比
开发者现在能用吗?
Step 5 Preview 已可通过 API 与线上平台调用,模型权重则要等 10 月 15 日释放。届时它可以和 GLM-5.3、DeepSeek 等已开源模型放进同一套本地部署对比。同一个发布窗口里还有两条相邻动态:智谱推出推理速度最高 200 tokens/s 的 GLM-5.3-FlashX,MiniMax 则以 MIT 协议开源了 Code CLI(第三方 30 题评测通过率 76.7%)。国产开源阵营正在「效率与成本」这条赛道上集体加速,选型窗口正在从「谁的榜单分高」转向「谁的单任务成本更低」。
❓ 常见问题
阶跃星辰宣布将于 2026 年 10 月 15 日正式开放模型权重。目前可先通过 API 与线上平台体验。
这是阶跃星辰给出的官方口径,指完成同等任务时 Step 5 Preview 的成本约为 Claude Opus 5 的 1/8。具体测算口径以官方披露为准,实际支出因任务类型和调用量而异。
原生支持文本与视觉(图片理解)输入,配备 100 万 Token 上下文窗口,适合长文档、大型代码库等需要长上下文的智能体任务。
在 AA 综合智能指数上,Step 5 Preview 与 Kimi K3 同为 44 分(参数量不到 K3 的 1/5),国产模型中仅次于 45 分的 Qwen3.8-Max 与 GLM-5.3。区别在于 Kimi K3 与 GLM-5.3 权重已开源,Step 5 Preview 需等 10 月 15 日。