文心 Unlimited OCR 2 开源:3623 页一次读完,KV 显存砍 96%(2026年10月)
文心 Unlimited OCR 2 开源:3B 总参、5 亿激活把文档解析推到不限页数,3623 页一次读完,单序列 KV 显存降 96.2%。但云端托管版单份 PDF 仍限 500 页,自建还是调 API 要看数据边界与页数。

一句话结论:百度 10 月 27 日开源的文心 Unlimited OCR 2 用 3B 总参、5 亿激活,把文档解析的页数上限从「数十页」推到「不设上限」——3623 页《哈利·波特》一次读完,单序列 KV 显存从 47.00GB 压到 1.77GB。它改的不是识别精度,而是知识库「入库」的成本结构。
为什么 1M 上下文的大模型读不完 100 页 PDF?
旗舰模型动辄 1M 上下文,按 token 算装几百页绰绰有余,实测常在百页级崩盘。百页基准 MarathonDocBench(103–300 页)上,Unlimited OCR 2 拿 77.06 分,第二名 33.74 分,Gemini-3.1-Pro 掉到 26.97 分,还有通用旗舰读到第 223 页直接中断。
病根是视觉 token。PDF 每页炸出上千个视觉 token,全注意力下每写一个字都要把前面所有页重算一遍,文档从 2 页加到 100 页,单步解码延迟从 3 毫秒涨到 27 毫秒。窗口够大,不等于注意力够用。
SR-SWA:先圈范围,再挑重点
第二代的核心是稀疏参考滑动窗口注意力(SR-SWA)。模型卡称它把文本-视觉注意力压到固定大小的工作参考集(如 512 个 token),单步延迟与显存占用基本不随文档长度增长。
拆开是两步:Page Gate 把每个查询的视觉范围从整份文档收缩到少数候选页;Token 筛子再在候选页里打分,只挑最相关的视觉块参与计算。官方称路由打分直接参与前向计算,不是蒸馏出的稀疏模式。
配套的无限解码机制解决显存:文档按窗口推进,相邻窗口只留一页「交接页」复用 KV 缓存,当前窗口转完历史缓存立即释放。百页测试集上单序列峰值 KV 显存从 47.00GB 降到 1.77GB(-96.2%),16 路并发 360 TPS 升到 1315 TPS,单步解码比标准全注意力快 7.0 倍、比一代 R-SWA 快 5.6 倍。
三关实测:3623 页、3000 笔流水、32 个陷阱
3623 页七部《哈利·波特》一次跑完 1 小时 30 分,平均 1.5 秒一页;四大名著拼成 5026 页整本塞进去,最后一页《红楼梦》收尾偈语完整输出。
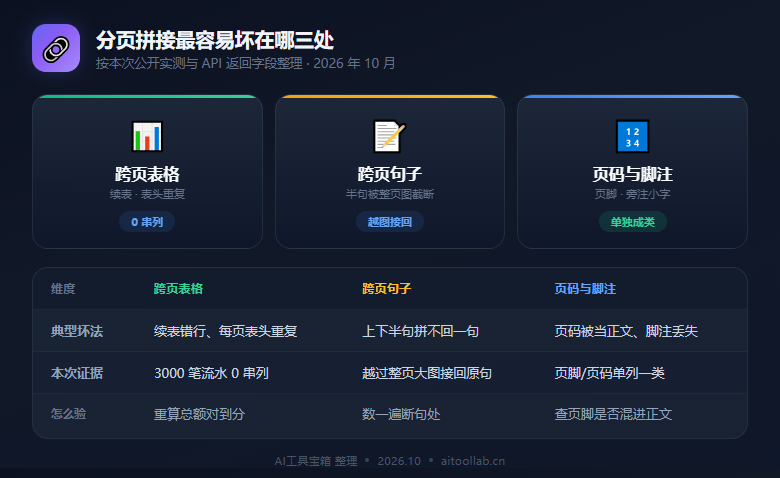
后两关更硬:300 页、3000 笔流水、暗掺 176 笔负数冲销的酒店总账,3000 条记录 0 漏项 0 重复,9000 个数字字段无一串列,求和 9,258,968.05 元与原账精确到分。240 页长卷埋的 32 个陷阱(形近的「叶文清」、被改成 724 页的第 742 页)也全部按纸面原样揪出,没按原著纠正。
自建还是调 API:三条路的真实边界
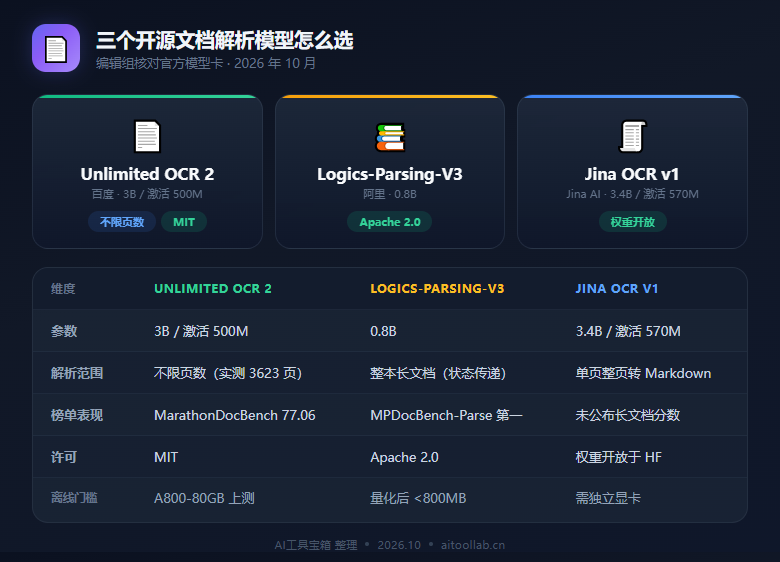
权重是 MIT 许可,截至 10 月 29 日仓库 29,510 Star。推理三条路:Transformers 原生(A800-80GB 上测)、SGLang(推荐做服务,需装定制 wheel,页窗口越小越省显存但跨页合并越差)、vLLM。
反差在这:开源权重号称不限页数,百度智能云的托管版却限定单份 PDF 最多 500 页(base64 不超 50MB、URL 不超 100MB),异步任务,QPS 2/5。「无限页」是模型能力,不是云端配额。
选型看数据边界:文档不能出内网、或单份超 500 页,只能自建;量小、偶尔解析合同财报,调 API 更省。接知识库时 RAGFlow、WeKnora 负责切片检索,解析层可替换;Unstructured 强在格式覆盖广。同赛道阿里 Logics-Parsing-V3 只有 0.8B、量化后不到 800MB 可离线跑。
它替不了什么
三件事官方没给答案:MIT 只覆盖代码与权重,训练数据来源与商用合规仍需法务确认;公开评测集中在 PDF 版式文档,手写体、低质量扫描件、竖排古籍无对应分数;「一次读完」依赖视觉 token 质量,低分辨率扫描件换不来精度。11 月 12 日百度世界 2026 会有更多技术细节。
数据说明:参数、SR-SWA 机制与 MPDocBench 84.59 分取自 Hugging Face 模型卡与雷峰网(10-27);MarathonDocBench 77.06 分、页数与显存实测取自新智元(10-28);API 限制取自百度智能云文档(10-27);Star 数取自 GitHub API(10-29)。
❓ 常见问题
开源权重本身没有页数上限,靠 SR-SWA 把每步解码的视觉参考集压到固定大小(如 512 token),3623 页实测未探到底。但百度智能云的托管版接口单份 PDF 最多 500 页,URL 上传不超过 100MB。
看页数和硬件。Unlimited OCR 2 是 3B 总参、5 亿激活,强在百页以上连续解析;Logics-Parsing-V3 只有 0.8B、量化后不到 800MB,能在笔记本离线跑,走的是跨页状态传递还原结构树。几十页合同选后者更轻。
官方测试机是 NVIDIA A800-80GB,没有公布最低显存。3B 权重按 BF16 估算约 6GB,剩下看并发与页窗口大小;SGLang 部署建议 mem-fraction-static 设 0.7,页窗口调小可降峰值显存但跨页合并会变差。
不能直接替代。它做的是把版面还原成结构化 Markdown/JSON(标题层级、表格、公式、脚注),不做问答和推理。正确用法是先用它把文档转成干净文本,再交给通用模型或知识库检索。
代码与权重的 MIT 许可允许商用与修改,但许可只覆盖软件本身,训练数据来源与具体业务场景的合规仍需自行确认。涉及合同、财报等敏感文档时,优先私有化部署避免数据出境。