MiniMax M3.1 Flash 量化实测:428B 压到 129GB,本地部署只剩内存门槛(2026年10月)
MiniMax M3.1-Flash 八档 GGUF 量化全部放出:最低 129.4GB、2-bit 143.9GB 就能跑 428B 旗舰模型,通用对话保留 88.5% 一致率。本文拆量化档位怎么选、DSpark 怎么开、你的机器能跑哪一档。


一句话结论:MiniMax M3.1-Flash 的 2-bit GGUF 把 428B 总参数的旗舰模型压到 143.9GB 下载体积,通用对话保留 88.5% 的 top-1 一致率、数学 95.7%。能不能跑不再是问题,值不值得跑才是。
2-bit 之后还剩多少能力?
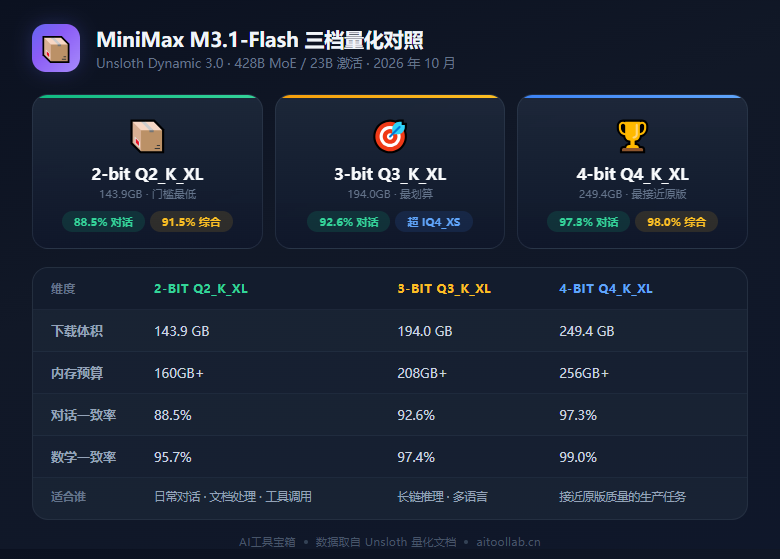
Unsloth 把能力拆成编程、数学、对话、工具、多语言、推理、智能体七个维度算 top-1 一致率:1-bit 的 UD-IQ1_M 约 89.9%,2-bit 的 UD-Q2_K_XL 91.5%,4-bit 的 UD-Q4_K_XL 98.0%。单看维度:2-bit 通用对话 88.5%、数学 95.7%,4-bit 升到 97.3% 与 99.0%。掉得最多的是闲聊,不是推理。
原因在模型卡里:M3.1-Flash 做了量化感知训练,路由专家和注意力路径在训练阶段就按低比特走过一遍,官方权重本身用 NVFP4 存 MoE 层、MXFP8 存其余部分。
八档量化怎么选:129.4GB 到 259.1GB
Dynamic 3.0 放出八档,下载体积从 UD-IQ1_M 的 129.4GB 到 UD-Q8_K_XL 的 259.1GB,中间六档依次 134.9、143.9、160.0、175.5、194.0、249.4(GB)。
内存口径是「内存加显存合计」,前提 16K 上下文、单并发槽,权重之外留 20-32GiB 给 KV 缓存与运行时。文档建议 2-bit 按 160GB+ 规划,硬件表给 150GB,按大的算。最划算的是 UD-Q3_K_XL:194.0GB,七个维度的 top-1 一致率全面超过通用 IQ4_XS 的约 230GB 版本,少 36GB 还更准。
DSpark 能再快 1.5 倍,但要自己编 llama.cpp
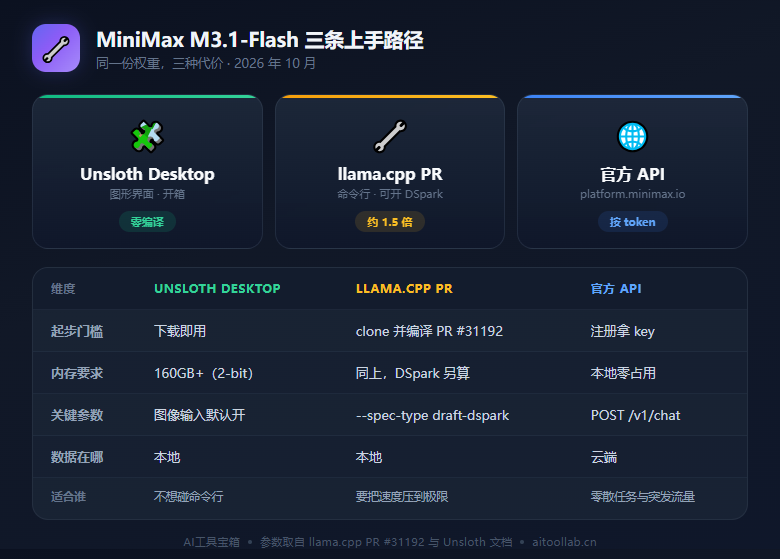
M3.1 把 EAGLE 式 MTP 换成 DSpark:草稿头先猜 token,主模型只做验证。官方把草稿头转成 GGUF(Q8_0,约 2.1GB),配 llama.cpp PR #31192 加 --spec-type draft-dspark、槽位固定 -np 1。Unsloth 实测 --spec-draft-n-max 1 时代码与数学约 1.5 倍,闲聊增益小。
这一步最不省事:clone 仓库、拉 PR 分支、编译。不想碰命令行就用 Unsloth Desktop;Ollama 与 LM Studio 跟着 llama.cpp 上游走,动手前先确认已支持这一代。
你的机器能跑哪一档?
MoE 每 token 只走 23B,但整份量化权重必须驻留内存——稀疏激活省算力,不省容量。按官方预算倒推:128GB 连最低一档都进不去,192GB 只够 2-bit 稳妥跑、3-bit 顶到天花板,256GB 才轮到 4-bit 卡线,512GB 才留得下长上下文余量。
长上下文、图像、DSpark 都要额外内存:视觉投影器 mmproj-BF16.gguf 约 1.74GB,上下文从 16K 往上翻,KV 缓存跟着涨。显存不够就 CPU offload 把专家层挪到内存,代价是速度。vLLM 适合多并发,单机试跑 llama-server 就够。
自己跑,还是买 API?
对照 DeepSeek-V4.1-Flash-1017 官方跑分:Automation-Bench v1.0.6 62.8 对 60.5、HLE 无工具 43.4 对 42.6 占优;Terminal Bench 4.0 38.1 对 42.3、DeepSWE v1.1 73.7 对 77.0、NL2Repo 61.2 对 68.2 落后。强项是多工具编排与长文档,不是纯终端里改仓库。
判断标准因此是任务形态:数据不能出内网、要跑 256K 以上长上下文、要批量压测,自托管值一次硬件钱;只是写代码或零散问答,买 API 更省,2-bit 本地还白掉 11.5% 一致率。第三条路是把 MiniMax 的托管接口接进 AnythingLLM 这类本地知识库前端,权重放云上、数据留本地。
数据说明:参数与官方跑分取自 MiniMax 模型卡,量化档位与一致率取自 Unsloth 文档(2026-10-27 核验),推测解码参数取自 llama.cpp PR #31192。
❓ 常见问题
通用对话 top-1 一致率 88.5%、数学 95.7%,日常问答、文档处理、工具调用够用;多步推理和长链编码建议直接上 4-bit,对应 97.3% 与 99.0%。
Unsloth 建议按 160GB 以上(内存加显存合计)规划,前提是 16K 文本上下文、单并发槽;同一份文档的硬件表给的是 150GB,取大的那个更稳。
跑不了。最低一档 UD-IQ1_M 下载体积就有 129.4GB,加上 KV 缓存与运行时已经超过 128GB,只能等更激进的量化或换机器。
支持。需要额外下载视觉投影器 mmproj-BF16.gguf(约 1.74GB),启动参数加 --mmproj,内存预算也要相应上调。
数据不能出内网、要跑 256K 以上长上下文、要批量压测,选自托管;零散问答和纯编程任务买 API,省下的硬件钱通常比省下的 token 钱多。