阿里千问公开 QwenGyre:长程智能体弹性 RL 框架,48 步涨 6 分(2026年10月)
阿里千问公开 QwenGyre,一套面向长程智能体任务的弹性在线强化学习框架。它把 GPU 在 rollout 与训练之间动态切换,用轨迹树与部分评分处理分支与超时,论文称 2.4T 模型 48 步在 NL2RepoBench 上从 52.5% 升到 58.5%、最高 1.85 倍提速,但代码尚未公开。


一句话结论:阿里千问 10 月 12 日公开 QwenGyre,一套面向「超长程」智能体任务的在线强化学习框架。它不提速推理,而是让训练集群在智能体连续跑几小时、单条 rollout 烧掉近 100 万 token 时不再空转。论文里 Qwen 3.8 2.4T 训练 48 步,NL2RepoBench 通过率从 52.5% 升到 58.5%,同算力下最高快 1.85 倍;但公开的只有论文,代码与许可证都没公布。
QwenGyre 是什么?长程任务为什么让 RL 训练卡住?
它是训练框架,不是模型。论文(arXiv:2609.33848)说的「xLong-Horizon」指一次执行持续数小时、交互数百轮、单条 rollout 接近 100 万 token,典型任务是从规格生成完整代码仓库——它用来训练的正是 Qwen3.8-Max 这类旗舰模型。
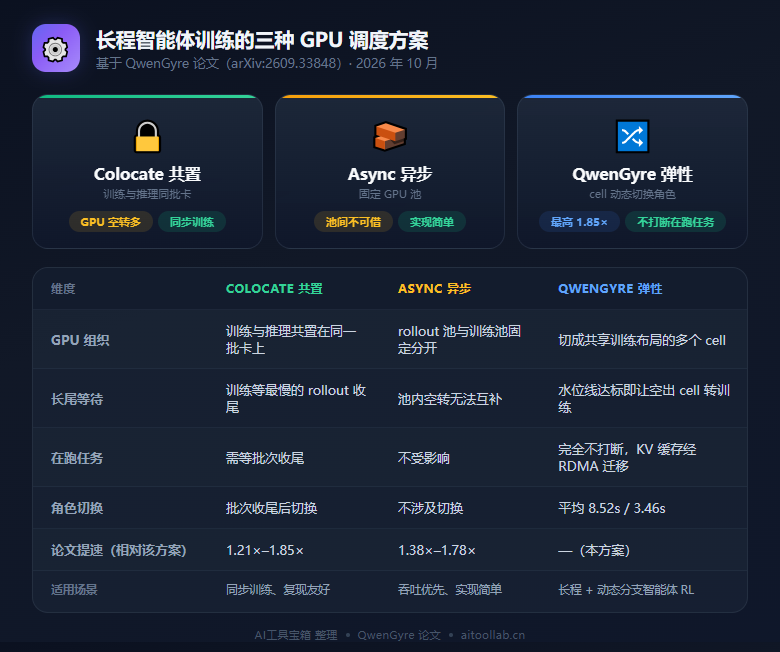
论文点名两个瓶颈:执行长尾,共置方案要等最慢的 rollout 收尾,异步方案的 rollout 池与训练池无法互借;分支冗余,harness 会压缩上下文、派生子智能体、失败重试,一次执行长成分支树,逐条展开会重复共享前缀。
弹性调度:把 GPU 在 rollout 和训练之间来回搬
QwenGyre 把 GPU 切成共享同一训练布局的 cell:core cell 持有权威权重,satellite cell 稍后加入。调度器跟踪 rollout 水位线(排队加执行中的任务量),只要剩余 cell 还扛得住在跑的活,空出的 cell 就转去训练,正在执行的智能体完全不被打断。切换时模型调用重路由到 proxy,KV-cache 块经 RDMA 迁移以减少前缀重算。论文给出的平均切换耗时是 rollout 转训练 8.52 秒、训练转 rollout 3.46 秒。
轨迹树与部分评分:没跑完的执行也算训练数据
proxy 用 TITO 记录每段输出的真实 token 与行为 log-prob,按共享前缀组织成轨迹树,只展开被选中的路径。超时但部分完成的任务按保留的工作区打分,评测器自身失败被排除而非记成 0 奖励。每次执行最多保留 5 条轨迹(main 优先),共享目标只算一次,只有策略生成的 token 参与训练,损失在每次执行内取平均;论文称 5 条上限与不设上限分数相当,前向-反向时间少 25.2%。底层用改造版 GSPO,每组 16 条 rollout。
论文数据与框架位置:1.85 倍提速,但代码未公开
122B 的 Qwen 3.6 跑在 24-32 节点,2.4T 的 Qwen 3.8 用 192 节点(4 个 48 卡 cell),训练用 Megatron、rollout 用 SGLang,harness 是未修改的 Claude Code 2.1.220。122B 上三类编码任务相对 Async 提速 1.38–1.57 倍、相对 Colocate 1.36–1.85 倍;2.4T 上相对 Async 1.78 倍、相对 Colocate 仅 1.21 倍,论文归因于该规模下很多查询贴着超时线跑。2.4T 跑完 48 步耗时 75.42 小时,Async 134.55 小时,Colocate 91.47 小时。
同类框架里 veRL(字节 Seed)、AReaL(清华 IIIS 加蚂蚁)都是 Apache-2.0,微软 Agent Lightning 是 MIT,而 QwenGyre 代码尚未公布,这是它最大的不确定性。想自己动手,可从 Qwen-Agent 搭起,或用 Qwen3-Coder-Next 跑通编码智能体链路;智能体自我改进的另一条路线,可对照 AI 智能体开始自己修 Bug 里的免奖励搜索。
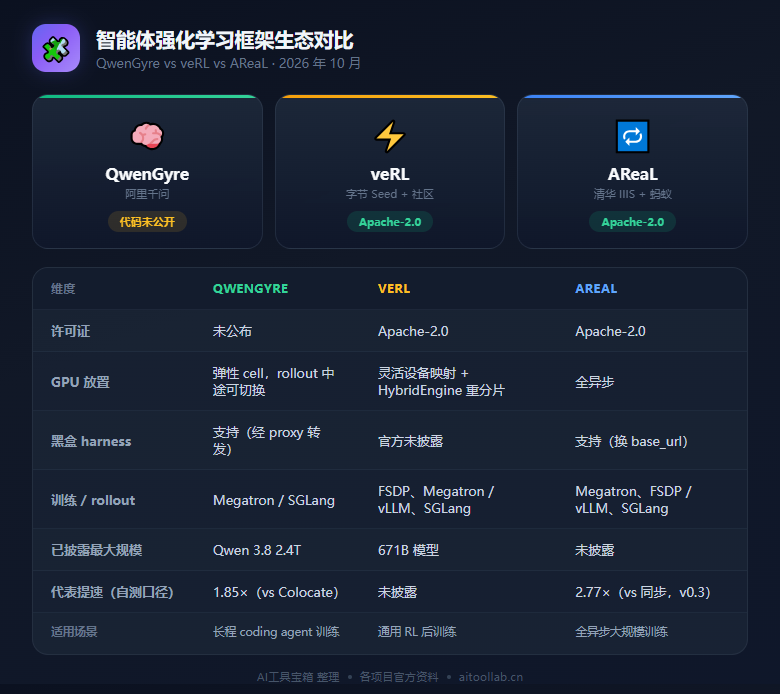
数据声明:本文数字均来自 Qwen 团队 arXiv 论文 2609.33848 及官方技术说明,未做独立复现。论文未披露 GPU 型号与全部消融实验,加速比为论文自测口径。
❓ 常见问题
是训练框架。QwenGyre 面向「超长程」智能体任务的在线强化学习,本身不产出模型能力,而是让数小时、数百轮交互、单条近 100 万 token 的 rollout 变成有效的训练来源。论文用它训练的对象是 Qwen 3.8 2.4T 与 Qwen 3.6 122B。
没有。截至发稿,Qwen 团队公开的是 arXiv 论文 2609.33848 与技术说明,论文页面没有给出代码仓库地址,许可证也未公布。部分自媒体称其「开源」,与论文披露的信息不符。
省的是 GPU 空转。共置方案要等最慢的 rollout 收尾,异步方案的 rollout 池与训练池无法互相借力。QwenGyre 把 GPU 切成共享训练布局的 cell,跟踪 rollout 水位线,只要剩余 cell 还扛得住在跑的任务,空出的 cell 就转去训练,且不打断正在执行的智能体。
靠 Partial Scoring。超时但部分完成的任务会按保留下来的工作区打分,评测器自身失败则被排除而不是记成 0 奖励。配合轨迹树,只有被选中的分支路径进入训练样本,共享目标只算一次,因此「半成品」也能提供有效梯度信号。
在 Qwen 3.6 122B 的三类编码任务上,QwenGyre 相对 Async 提速 1.38–1.57 倍、相对 Colocate 1.36–1.85 倍;2.4T 模型上相对 Async 1.78 倍、相对 Colocate 1.21 倍。2.4T 跑完 48 步用时 75.42 小时,Async 为 134.55 小时,Colocate 为 91.47 小时。