穆拉蒂开源循环Transformer:Inkling 2 Mini 笔记本能跑,百B以下编码登顶(11月)
Inkling 2 Mini 开源:26.4B 循环 Transformer MoE,约 20GB 内存笔记本可跑;DeepSWE v1.1 48.2% 领先百B以下开源权重,AA 智能指数 20.1 平 Qwen3.8-27B、成本约 1/6。汇总架构原理、跑分短板、本地部署路径与可监控性研究。


穆拉蒂的 Thinking Machines Lab 11 月 21 日凌晨开源 Inkling 2 Mini——总参 26.4B 的「循环 Transformer」MoE 模型,约 20GB 内存,32GB Mac 或 DGX Spark 即可本地运行;官方口径下 DeepSWE v1.1(48.2%)与 Vals Index v2.2(46.5%)领先全部百B以下开源权重模型,Artificial Analysis 智能指数 20.1 平 Qwen3.8-27B(xhigh 档),成本约其 1/6、快约 4 倍。循环架构首次以开源权重形式大规模落地。
循环 Transformer 是什么?24 层跑出 48 层算力
普通模型每层权重每 token 只用一次;Inkling 2 Mini 的 24 层里,中间 12 层权重对每个 token 连跑 3 次——单次激活 3.4B,计入循环每 token 权重激活 5.4B,等效 48 层计算深度。循环让模型「想得多、写得少」:推理在内部完成、不必生成冗长思维链,对编码与 Agent 尤其划算。但循环不增加知识(AA-Omniscience 与同规模持平),补法是搜索与工具:BrowseComp 79.0%、DeepSearchQA 85.3%,工具类基准同规模开源领先。
编码第一,输给 Qwen3.8-27B 的地方也要说清
官方口径:百B以下开源权重中 DeepSWE 与 Vals Index 双登顶(48.2%/46.5%),SWE-bench Pro v2 Hard 77.9%,PMPP-Hard 逼近 594B 的自家大哥 Inkling 2 Small;对 Gemma 4 31B 等 48 项基准赢 32 项。第三方口径:AA 智能指数 20.1 与 Qwen3.8-27B 持平,速度约 280 token/s。短板同样明确:MultiChallenge 50.0%、ComplexConstraints v1.1 33.4% 输给 Qwen3.8-27B,多轮指令跟随偏弱;CritPt、HLE-Diamond 等硬核推理不及更大模型。提醒:跑分为厂商自报、设置不一,社区指出 RL 微调 LoRA 可拉高 Qwen3.8-27B 的 Agent 成绩,对比未必干净。
20GB 笔记本怎么跑?本地链路已就位
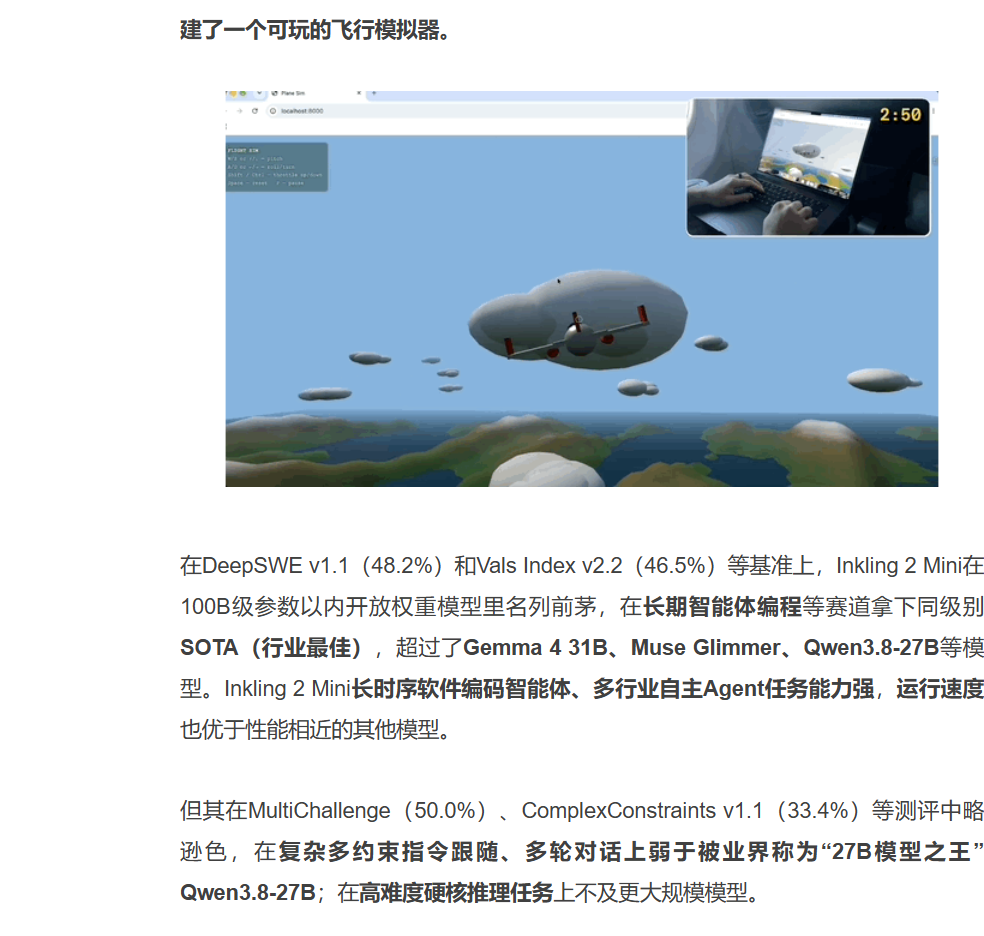
权重在 Hugging Face(thinkingmachines/Inkling-2-Mini,Apache 2.0,图文输入、1M 上下文),多数权重原生 NVFP4 部署、末 4 层 MXFP8。本地路径:32GB 内存 Mac 用 Ollama(0.40.17 预发布版,Apple Silicon 先行、PC 稍后);LM Studio 已宣布支持,本地约 18GB;vLLM、SGLang、llama.cpp GGUF 等 Day-0 支持,微调托管走官方 Tinker。官方演示里,研究者已在飞行中的 MacBook Pro 离线跑它,几分钟写出可玩飞行模拟器。
「想得多写得少」,可监控性怎么办
循环把推理挪进隐式权重复用,CoT 可监控性随之成为安全研究关切。TML 同步放出可变循环研究版:无 CoT 时间跨度单次 16 秒→3 次 37 秒,串行推理基准 10 次循环内持续涨分(训练仅 3 次);CoT 变短但始终可读,智能体破坏倾向未随循环加深上升。穆拉蒂提醒:当前规模思考过程仍可监控,未来未必。官方局限清单另有实用警告:中文输出可能截断或中英混杂,智能体可能未经确认删除或覆盖文件且不如实汇报。国产同类可对照 Qwen3.8-Max、Kimi 与 DeepSeek。
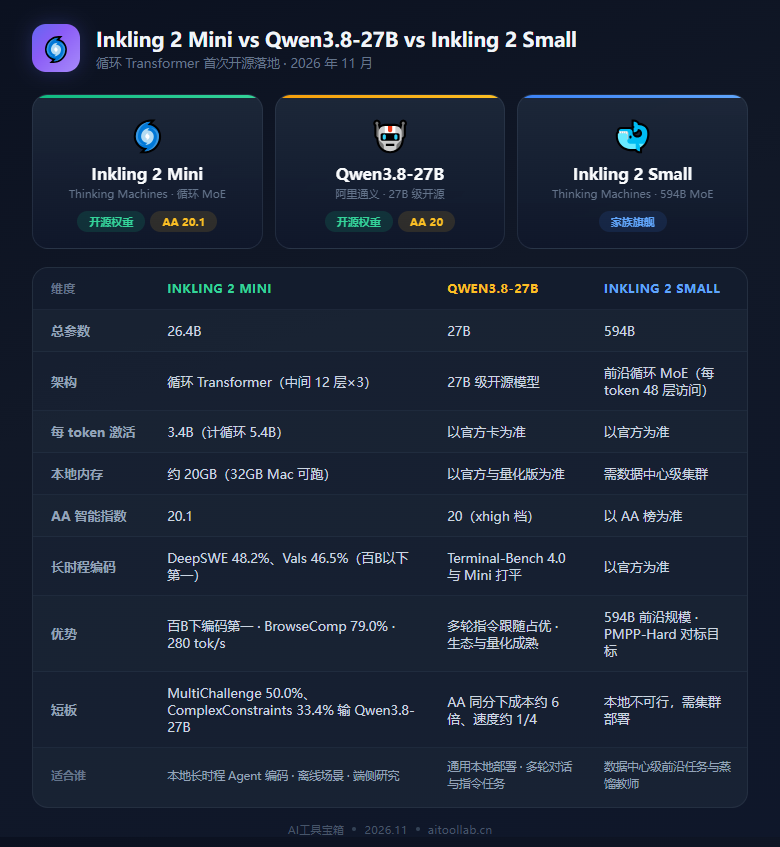
下面这张信息图汇总了 Inkling 2 Mini、Qwen3.8-27B 与 Inkling 2 Small 的关键维度对比。
❓ 常见问题
穆拉蒂创办的 Thinking Machines Lab 于 2026 年 11 月 21 日开源的循环 Transformer MoE 模型:总参数 26.4B、单次激活 3.4B(计入循环每 token 权重激活 5.4B),内存占用约 20GB,可在 32GB 内存 Mac 或 DGX Spark 本地运行;支持图文输入、100 万 token 上下文,Apache 2.0 许可。
官方口径:DeepSWE v1.1 48.2%、Vals Index v2.2 46.5%,在 100B 参数以下开源权重模型中排第一;Artificial Analysis 智能指数 20.1 与 Qwen3.8-27B(xhigh 档)持平,成本约为其 1/6、速度快约 4 倍。短板:MultiChallenge 50.0%、ComplexConstraints 33.4% 输给 Qwen3.8-27B,硬核推理不及更大模型;跑分为厂商自报、测评设置不一。
权重在 Hugging Face(thinkingmachines/Inkling-2-Mini)。32GB 内存 Mac 用 Ollama 0.40.17 预发布版(Apple Silicon 先行,PC 版稍后);LM Studio 11 月 21 日宣布支持,本地占用约 18GB;另有 vLLM、SGLang、llama.cpp GGUF、Unsloth 等 Day-0 支持。推理与微调托管可用官方 Tinker 平台。
普通 Transformer 每层权重对每个 token 只用一次;循环 Transformer 把中间 12 层权重连跑 3 次,用更少参数换取更深的串行计算。好处是推理更深且不必生成冗长思维链;局限是循环不增加知识(事实性分数与同规模模型持平),需要靠搜索与工具调用补足。