PyTorch 原生跑上 TPU:推理成本被压到每百万 token 2 美分(2026年10月)
Google 与 Meta 开源 TorchTPU,PyTorch 只需改一行 device 就能跑 TPU。本文拆解 4,917 个模型验证结果、每百万 token 2.01 美分的基准成本,以及 llm-d 1.0 与 DeepInfer 开源后,自建推理该怎么算账。


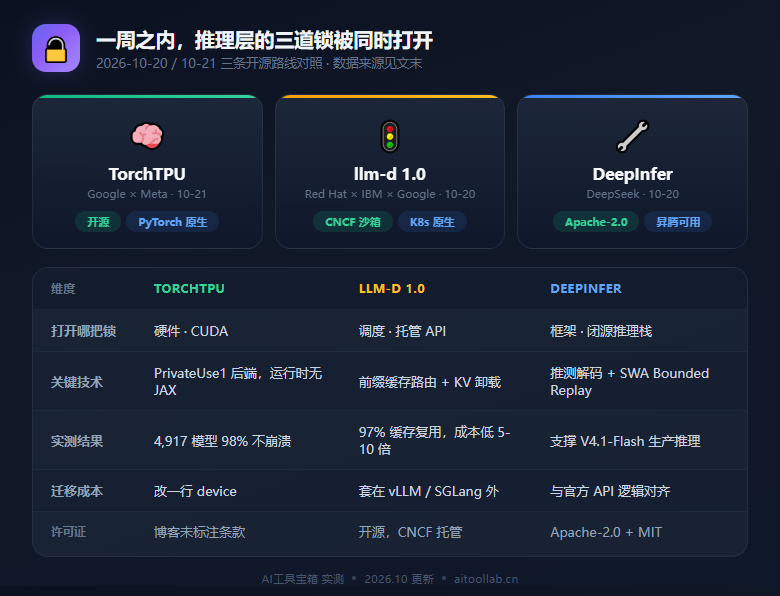
PyTorch 现在能直接跑在 TPU 上了。2026 年 10 月 21 日,Google 与 Meta 的 PyTorch 团队开源 TorchTPU,迁移只需把 .to("cuda") 改成 .to("tpu"),运行时不再依赖 JAX;配套的 vLLM-TorchTPU 在 Ironwood 上跑出每百万 token 2.01 美分。同一周,llm-d 1.0 与 DeepSeek 的 DeepInfer 也开源。
PyTorch 上 TPU,绕开了哪道坎
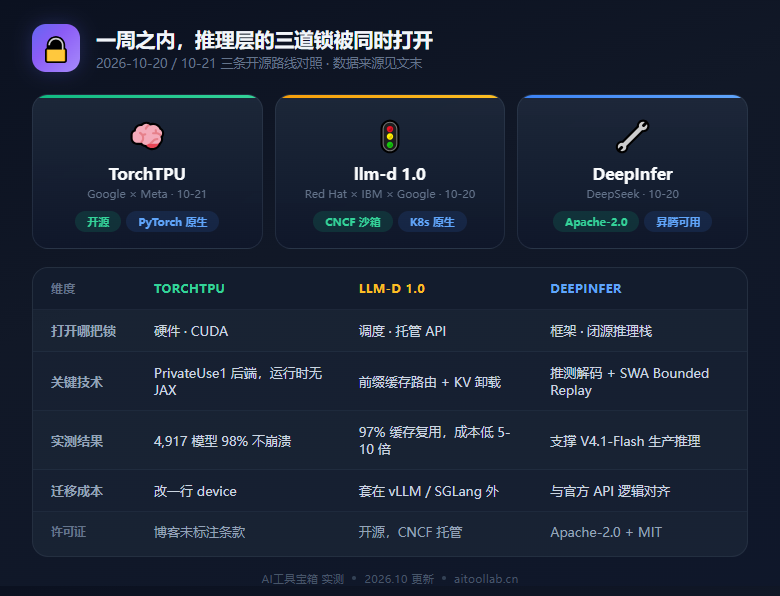
过去只能走 PyTorch/XLA:要侵入式改源码圈出可编译区域,编译延迟明显,还不支持 eager 执行。TorchTPU 把 TPU 注册成 PyTorch dispatcher 的 PrivateUse1 后端,运行时没有 JAX,torch.compile 走 TorchDynamo 而非 Lazy Tensor,集合通信下沉到 Process Group 层,DDP、FSDP、DTensor 直接可用。
官方覆盖度:4,917 个 Hugging Face 模型,98% 不崩溃、97% 与 GPU 数值一致;30B 模型在单块 TPU v7 上 prefill 约 25.7k TPS、MFU 59%。
同一周,调度层和框架层也被打开
10 月 20 日北美 PyTorch 大会上,llm-d 发布 1.0。由 Red Hat、IBM、Google 主导的分布式推理网络,可与 vLLM 或 SGLang 配合。1.0 的重点不是新算法,是「第 2 天运维」:多租户竞争优先级、零停机升级、把多轮请求钉在持有缓存的副本上。智能体编码负载实测捕获 97% 可用缓存复用;自托管跑 3,000 个软件工程智能体,成本比按服务价买同一开放模型低 5-10 倍。
两天前 DeepSeek 把内部推理框架 DeepInfer 全面开源(Apache-2.0),同步放出 Token 编解码组件 deepseek-recipe(MIT),支持分布式推理、推测解码、SWA Bounded Replay、结构化输出,英伟达与昇腾都能跑。
每百万 token 2 美分,这个数怎么读
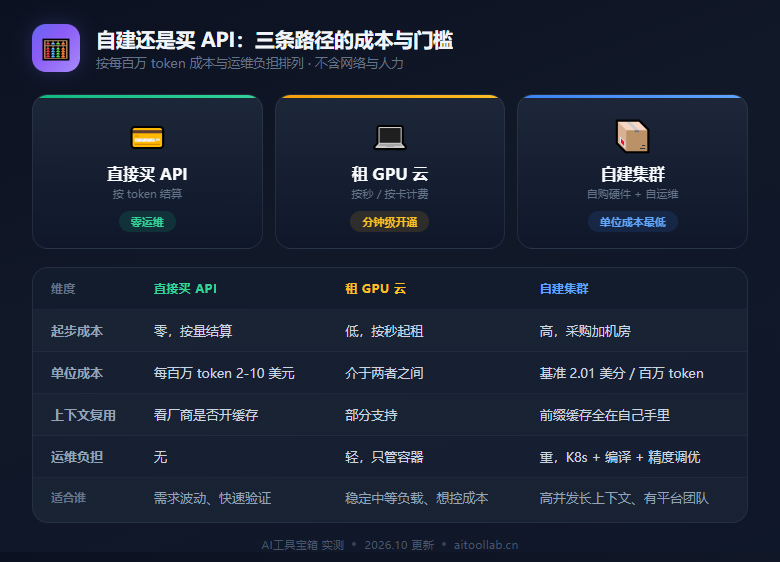
2.01 美分来自 SemiAnalysis 的 InferenceX 基准(8K 输入、1K 输出),TPU v7 上的 vLLM-TorchTPU,比 9 月首次亮相的 3.6 美分降了四成;AgentX 场景 0.83 美分。这是基准测算成本,不是价目表,前提是机器自购、折旧自摊。
另一头,Gemini 4 Argon 早鸟价是每百万 token 输入 2 美元、输出 10 美元,11 月 30 日后翻倍。同样是个「2」,一个美分一个美元,中间差的是你要承担的工程。
谁该自建,谁继续买 API
三条判断线。上下文复用率:智能体反复读同一份代码库、同一批文档,前缀缓存才值钱,一次性问答收益很薄。负载是否稳定:自建是固定折旧,跑不满就是在替闲置的卡付钱。团队有没有 K8s 运维能力:llm-d 的价值建立在有人守夜的前提上。
想小步验证,RunPod 这类按秒计费的 GPU 云比自建机房更容易算出真实单位成本;Modal 的 Sticky Sessions 用 @modal.sessioned() 把同一会话请求固定到同一容器。
还没解决的三件事
TorchTPU 的许可证,PyTorch 博客原文没有标注具体条款,商用前得去仓库确认。有界动态性(SymInt)尚未默认启用,动态 shape 仍靠最大上限预分配。多程序多数据默认走 Skinny Collectives,官方写明有 30-40% 性能损失。精度默认 medium(BF16 乘法加 FP32 累加),切到 high 约 3 倍成本、highest 约 6 倍——为收敛调精度,账单先动。
数据说明:数字取自 PyTorch 官方博客(2026-10-21)、llm-d 官方博客(2026-10-20)、DeepSeek 公告(2026-10-20)与 SemiAnalysis InferenceX 基准;成本为公开基准测算。
❓ 常见问题
最核心的区别是运行时不再依赖 JAX。PyTorch/XLA 需要侵入式改源码圈出可编译区域、编译延迟明显、不支持 eager 执行;TorchTPU 把 TPU 注册成 PyTorch 的 PrivateUse1 后端,eager 是首要优先级,torch.compile 走 TorchDynamo 而非 Lazy Tensor,集合通信下沉到 Process Group 层,DDP、FSDP、DTensor 可以直接用。
官方口径是极少改动:模型侧 device 从 cuda 改成 tpu,分布式后端从 nccl 改成 tpu_dist。想要一份代码同时跑两种硬件,用 torch.accelerator.current_accelerator() 取当前加速器、init_process_group() 不指定后端即可。真正要重写的是自定义 CUDA kernel,需要换成 Pallas 或 Tokamax。
不是。这是 SemiAnalysis InferenceX 基准(8K 输入、1K 输出)在 TPU v7 上跑 vLLM-TorchTPU 测算出的成本,属于自建场景的机器折旧摊销,不含网络、存储和人力。对比参照:Gemini 4 Argon 早鸟价是每百万 token 输入 2 美元、输出 10 美元,11 月 30 日后翻倍。
它解决的是部署之后的问题——多租户竞争优先级、零停机升级、把多轮请求钉在持有前缀缓存的副本上。这些能力只有在负载稳定、并发足够高、并且有人长期值守 Kubernetes 时才划算。团队没有 K8s 运维能力时,自建的隐性成本会吞掉推理省下的钱。
它是国产大模型第一次把支撑生产推理的框架整体开源(Apache-2.0),并且同一套框架兼容英伟达和华为昇腾。对用量敏感的自动化流水线来说,硬件选择不再被单一生态绑死,换硬件时可以复用同一套推理栈与调优经验,而不是重写一遍部署。